Como rotular defeitos para inspeção visual com IA: guia de anotação com bounding box

O primeiro modelo de detecção de defeitos que treinamos era péssimo, e a culpa foi nossa. As fotos estavam boas e o modelo também. As caixas que desenhamos em volta dos defeitos estavam uma bagunça, e o modelo aprendeu exatamente o que mostramos a ele, que era confusão.
Desde então rotulamos muitas peças, assim como as pessoas com quem trabalhamos, e o mesmo punhado de coisas sempre volta a aparecer. Nenhuma delas é complicada. A maioria é óbvia depois que alguém aponta. Este texto é esse alguém apontando.
Resumo rápido
Tire fotos de ângulos, distâncias e iluminações diferentes para que o modelo aprenda o defeito e não o cenário. Depois rotule todos os defeitos em todas as imagens, desenhe cada caixa bem justa, rotule sempre do mesmo jeito, deixe que caixas de tipos de defeito diferentes se sobreponham e comece com classes detalhadas que você pode juntar depois. Na prática, uma caixa honesta vale mais que dez esquecidas, amostras confusas ficam fora do dataset e, se duas pessoas desenhariam de um jeito diferente, a caixa provavelmente está errada.
Tirar as fotos: um princípio
Um modelo generaliza a partir da variedade. Se todas as fotos de um microfuro forem tiradas do mesmo lugar e sob a mesma lâmpada, ele aprende aquele lugar e aquela lâmpada, e na primeira vez que uma peça chega um pouco girada ele fica nervoso. Por isso, a única coisa que vale a pena fazer ao coletar imagens de treinamento é se mexer.
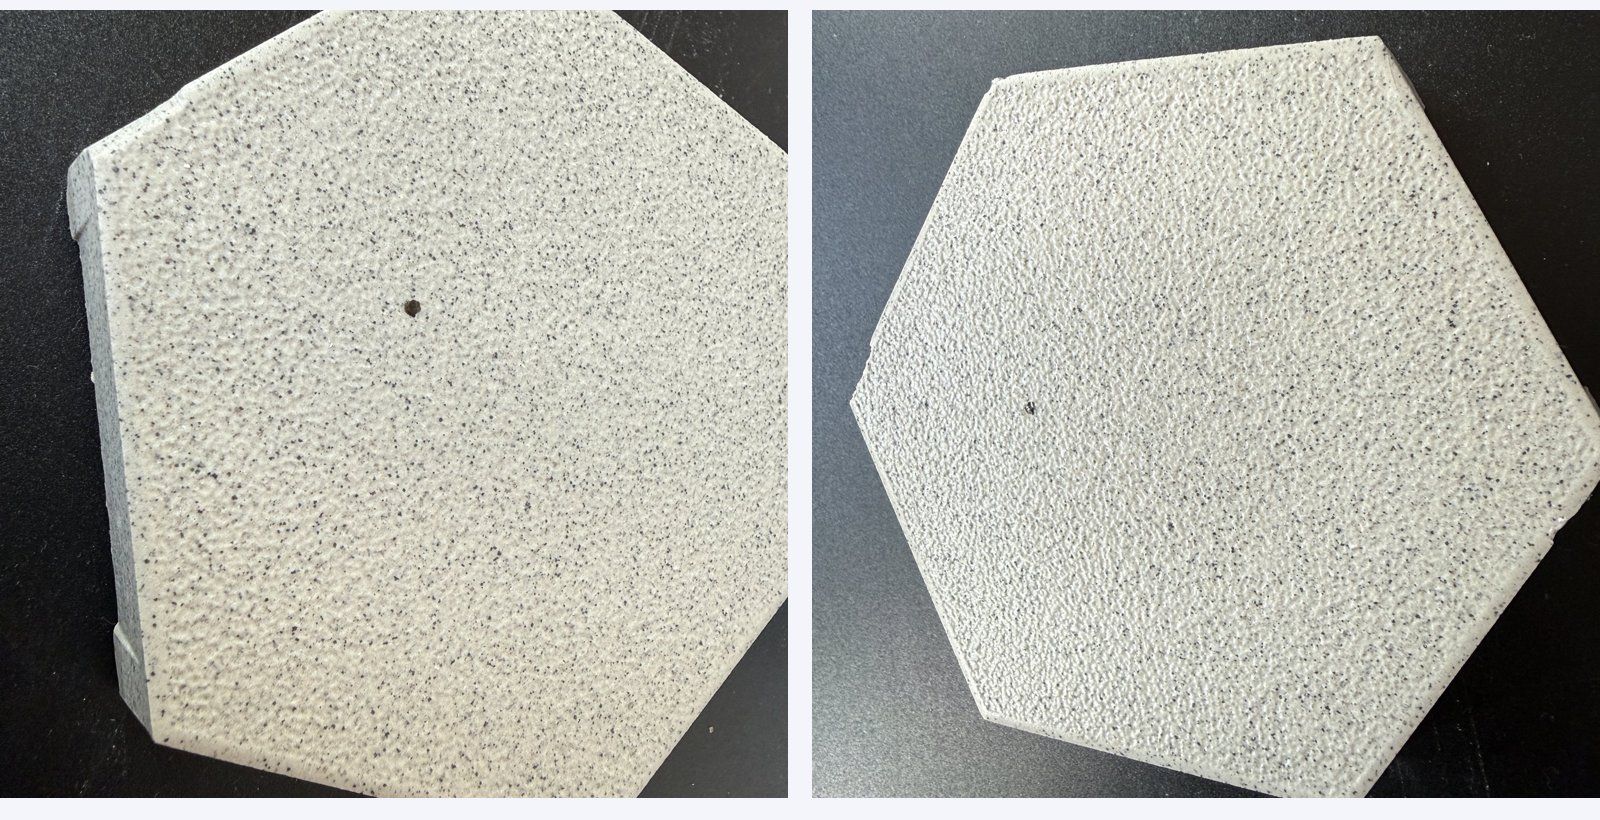
Ângulos diferentes. Dê a volta no defeito e fotografe de alguns lados. O mesmo microfuro parece diferente de frente e a 45 graus, e o modelo precisa conhecer os dois.
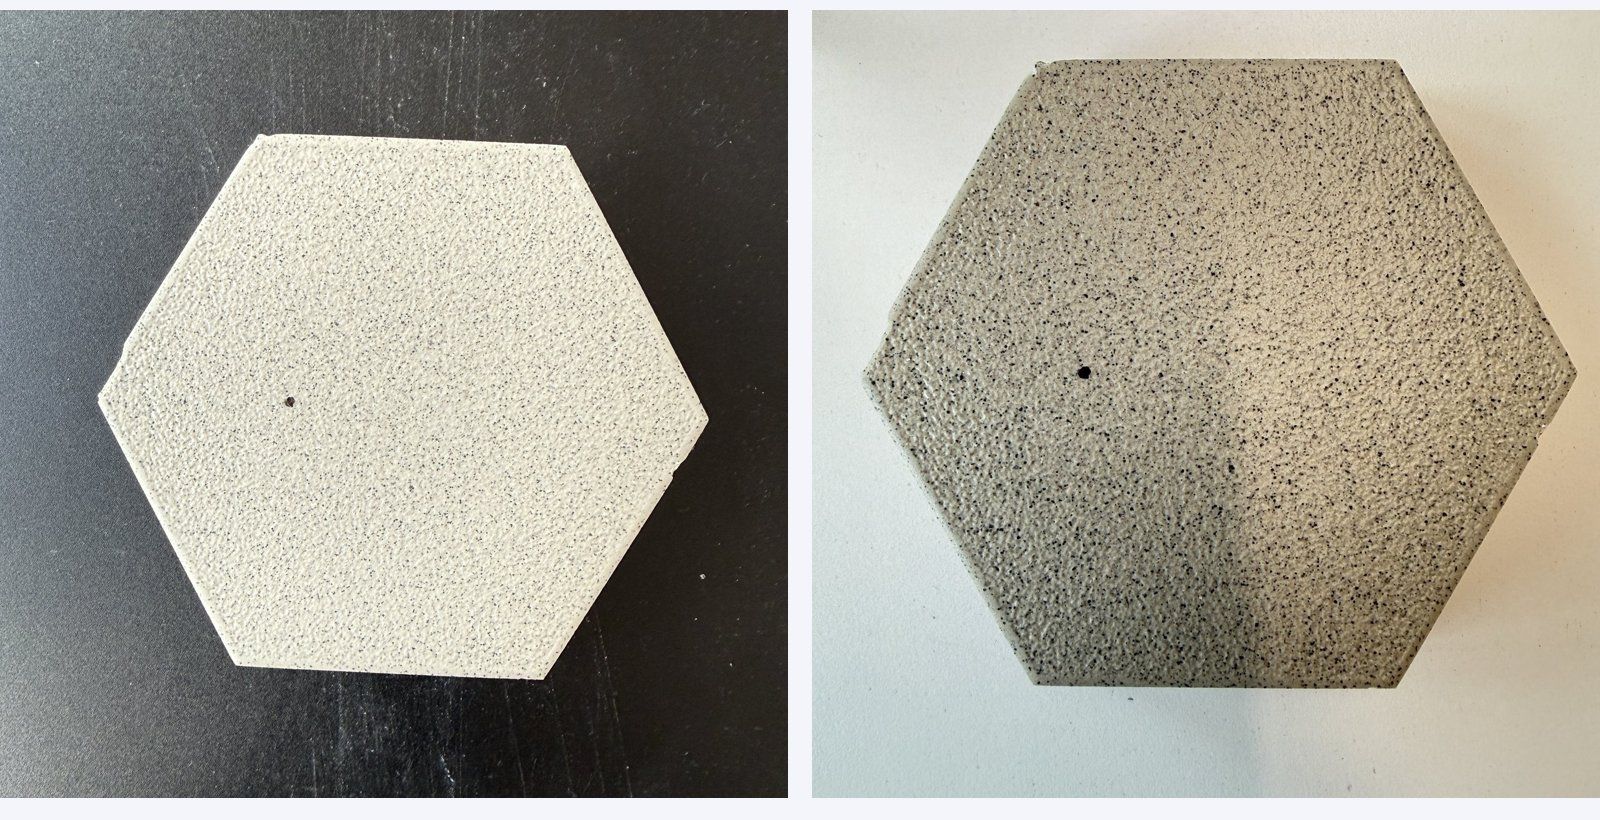
Luz e fundo diferentes. Claro, escuro, na sombra, na bancada, na linha. Mudar o fundo é como o modelo aprende a ignorá-lo.
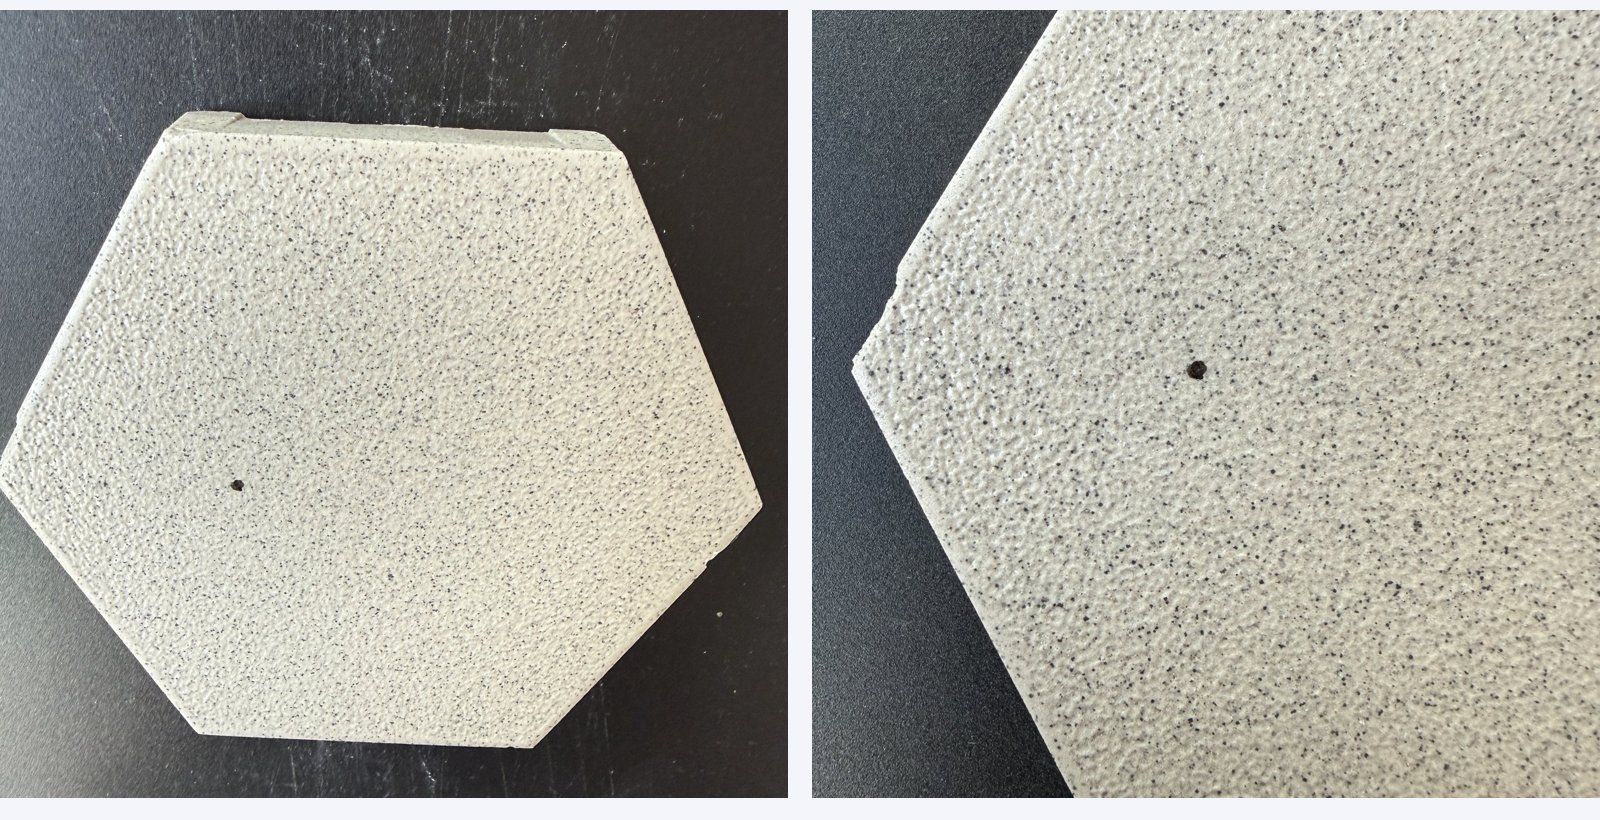
Distâncias diferentes. Chegue perto, depois se afaste. Um defeito que ocupa a imagem inteira e um defeito que é só um pontinho no canto são coisas que o modelo vai ver na produção.
Se a sua câmera fica fixa na linha, nada disso é problema. Uma posição fixa dá imagens muito consistentes e um modelo muito bom naquela única vista. A variedade importa mais quando o iPhone é usado na mão ou quando um modelo precisa cobrir mais de um posto.
Rotulagem: cinco pilares
Estas não são regras da Enao. Elas valem para qualquer anotação de imagens para detecção de objetos e fazem a diferença entre um modelo confiante e um que vive pedindo para você conferir de novo.
1. Rotule todos os defeitos da imagem
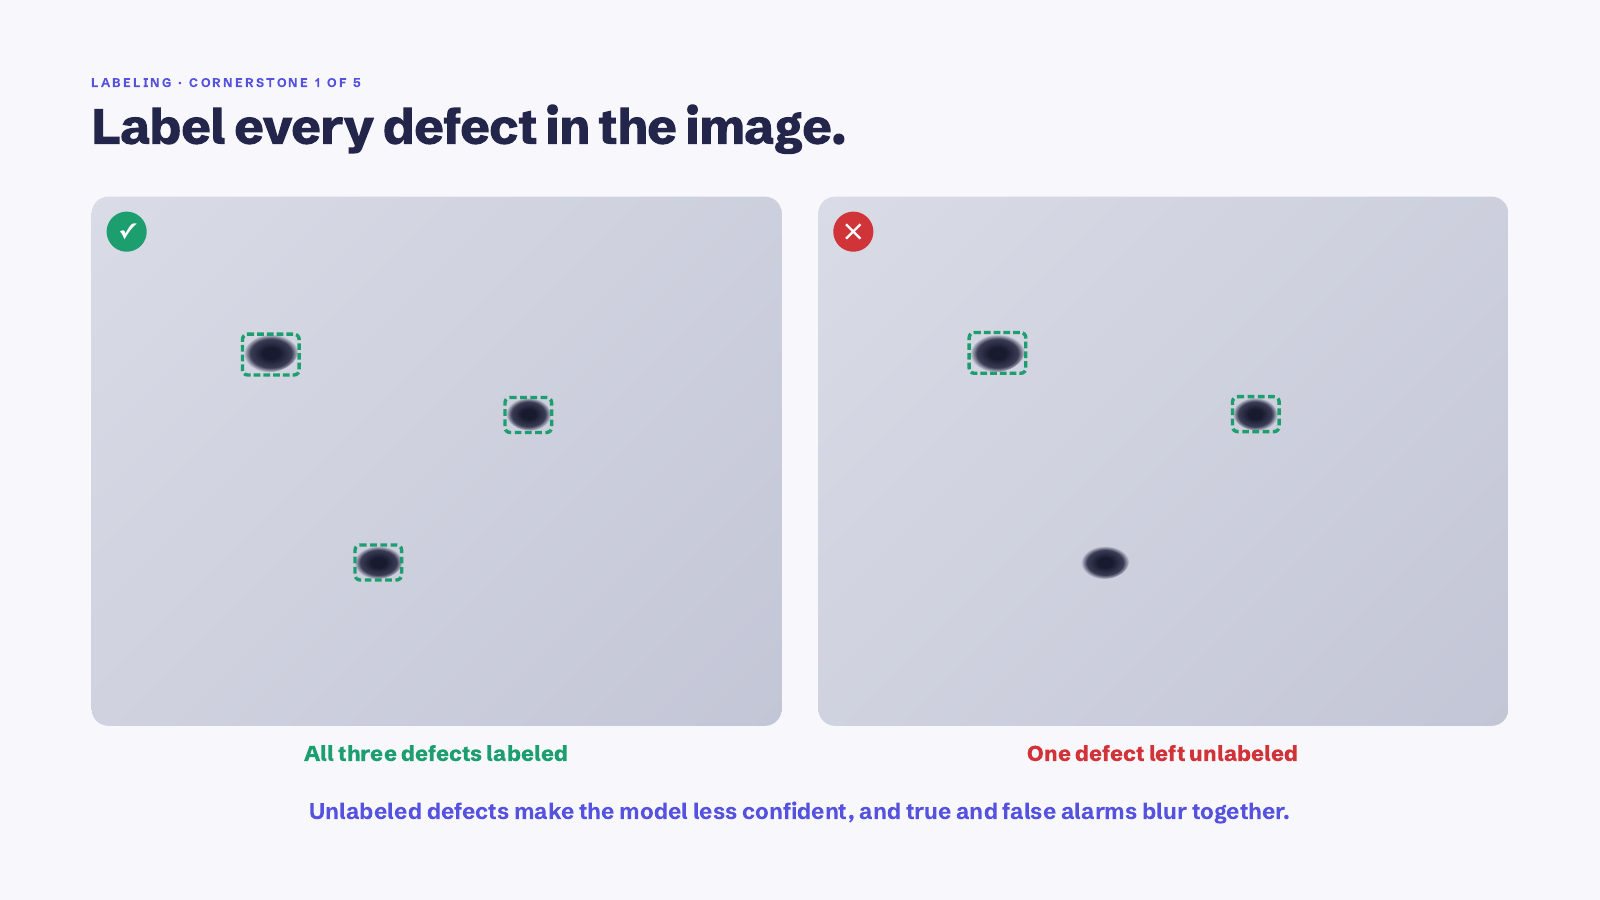
Foi aqui que erramos primeiro. Se uma imagem tem três defeitos e você coloca caixa em dois, acabou de dizer ao modelo que o terceiro é fundo. Faça isso algumas dezenas de vezes num dataset e os alarmes verdadeiros e os falsos começam a se confundir, porque o mesmo padrão foi mostrado das duas formas. Se você consegue ver, coloque uma caixa.
2. Desenhe a caixa justa em volta do defeito
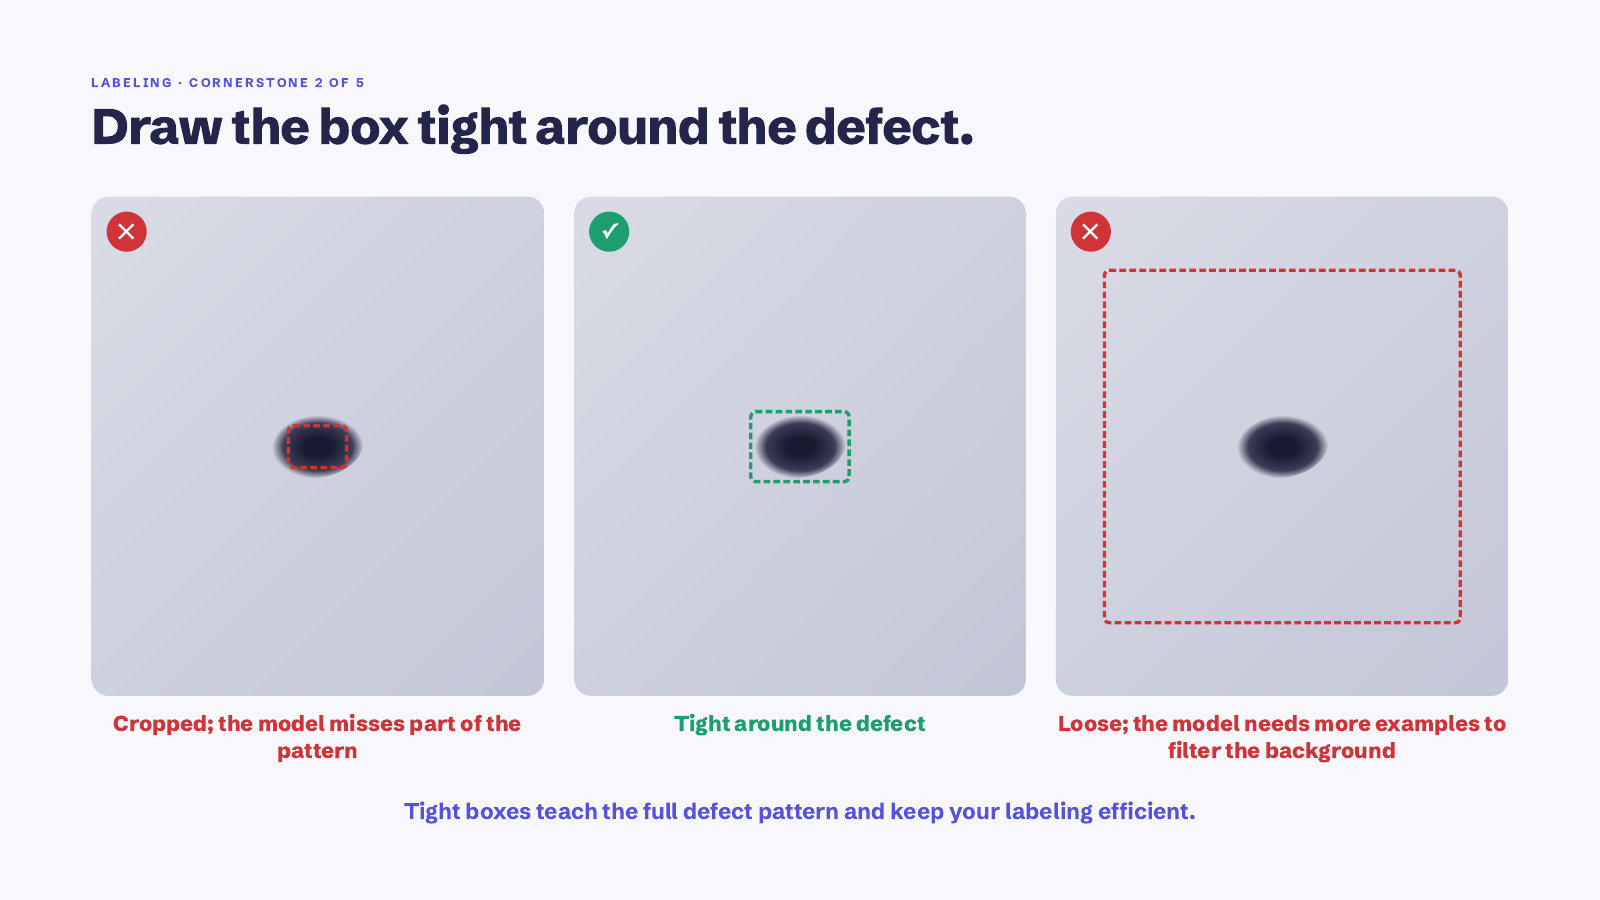
Uma caixa justa com alguns pixels de margem ensina o padrão completo do defeito e nada mais. Corte demais e parte do padrão se perde. Deixe folgada e o modelo precisa aprender a ignorar todo aquele fundo, o que exige mais exemplos do que qualquer um quer rotular. A caixa justa ainda por cima é mais rápida de desenhar, o que é um bom bônus.
3. Rotule sempre do mesmo jeito
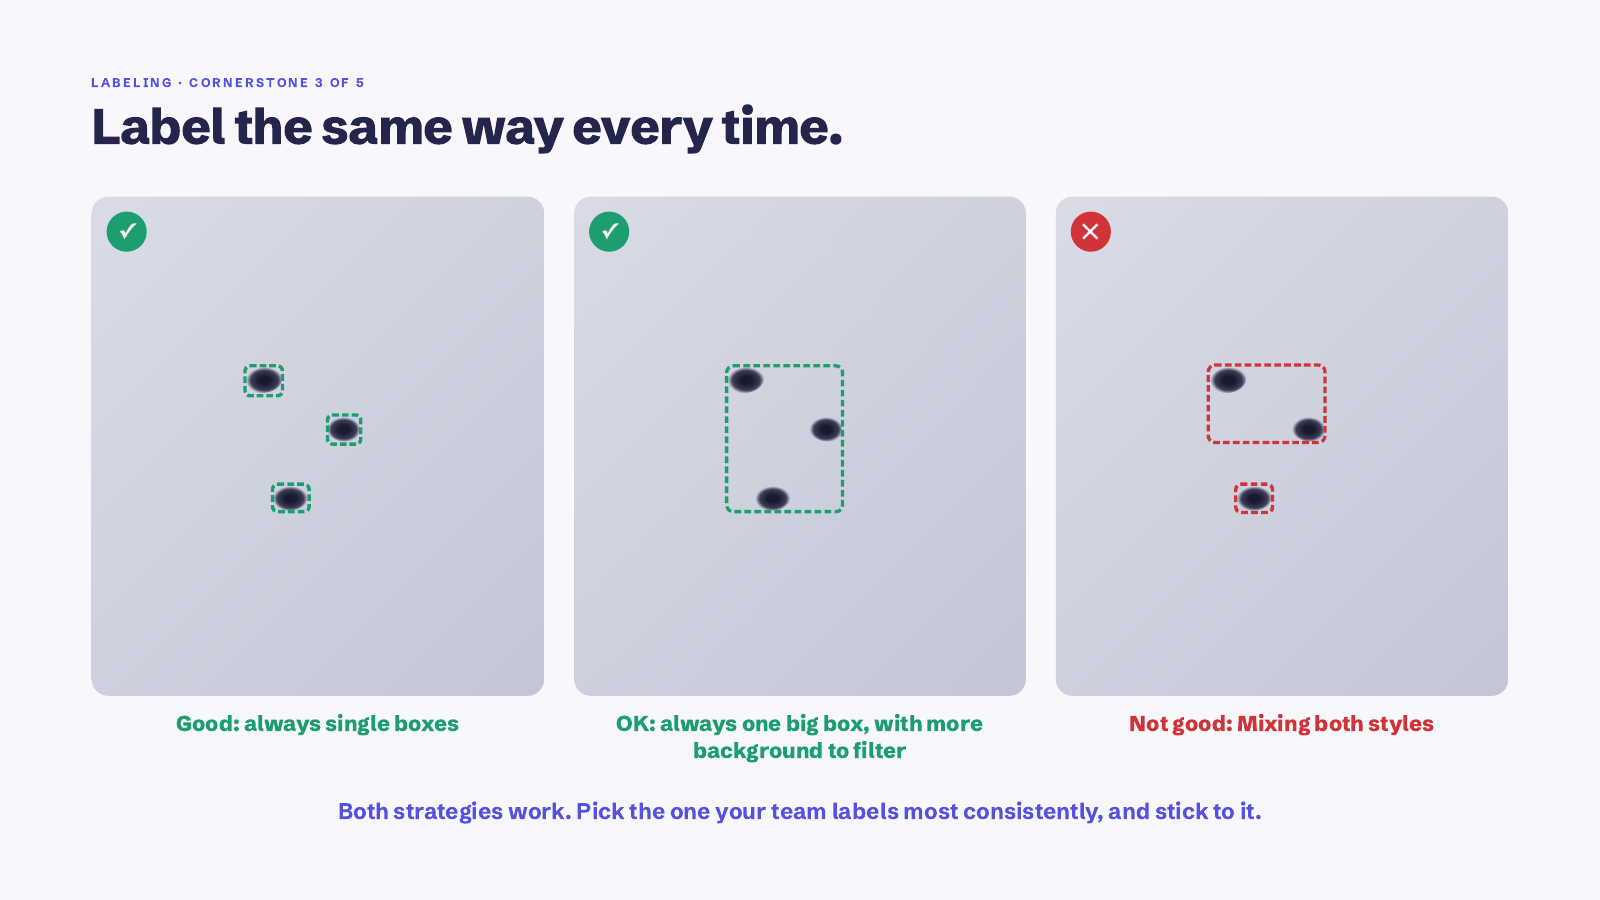
Existem duas formas perfeitamente boas de lidar com um aglomerado de defeitos pequenos. Coloque uma caixa em cada um ou desenhe uma caixa em volta do grupo. As duas funcionam. O que não funciona é fazer um pouco de cada, porque aí o modelo vê a mesma situação rotulada de dois jeitos e não consegue decidir. Escolha a que a sua equipe acha mais fácil de fazer com consistência e anote isso em algum lugar.
4. Caixas sobrepostas de defeitos diferentes não são problema
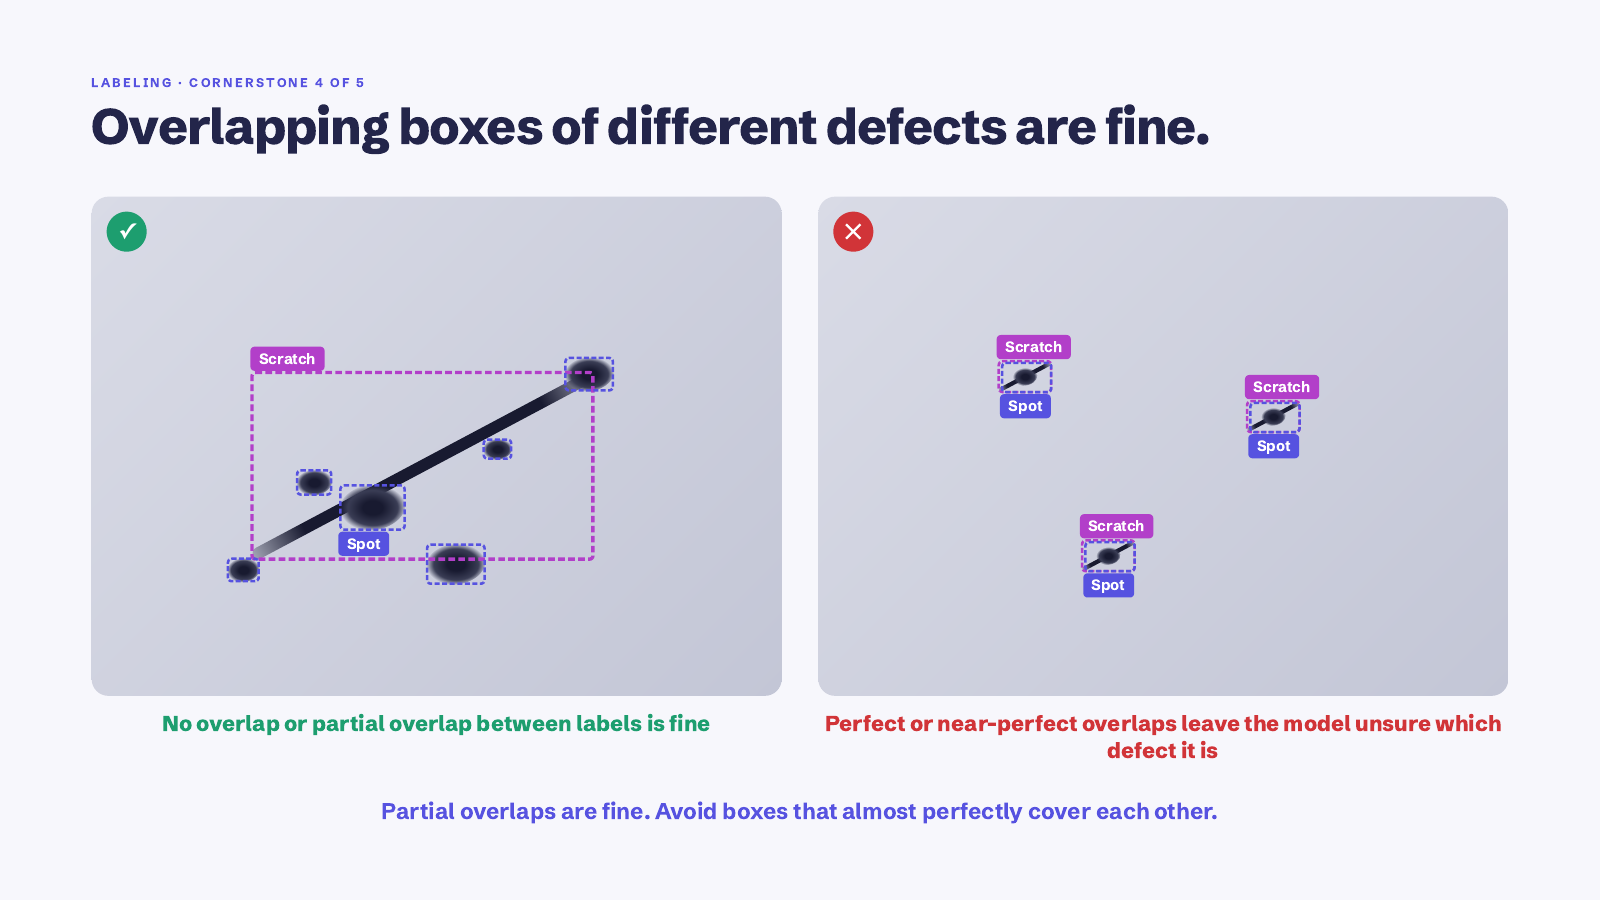
Um risco passando por uma mancha é a vida normal. Coloque uma caixa no risco, outra na mancha e deixe que se sobreponham. Sobreposição parcial não causa problema nenhum. O que você deve evitar são duas caixas de classes diferentes praticamente uma em cima da outra, porque aí não há como aprender a qual classe os pixels pertencem.
5. Comece detalhado, junte depois
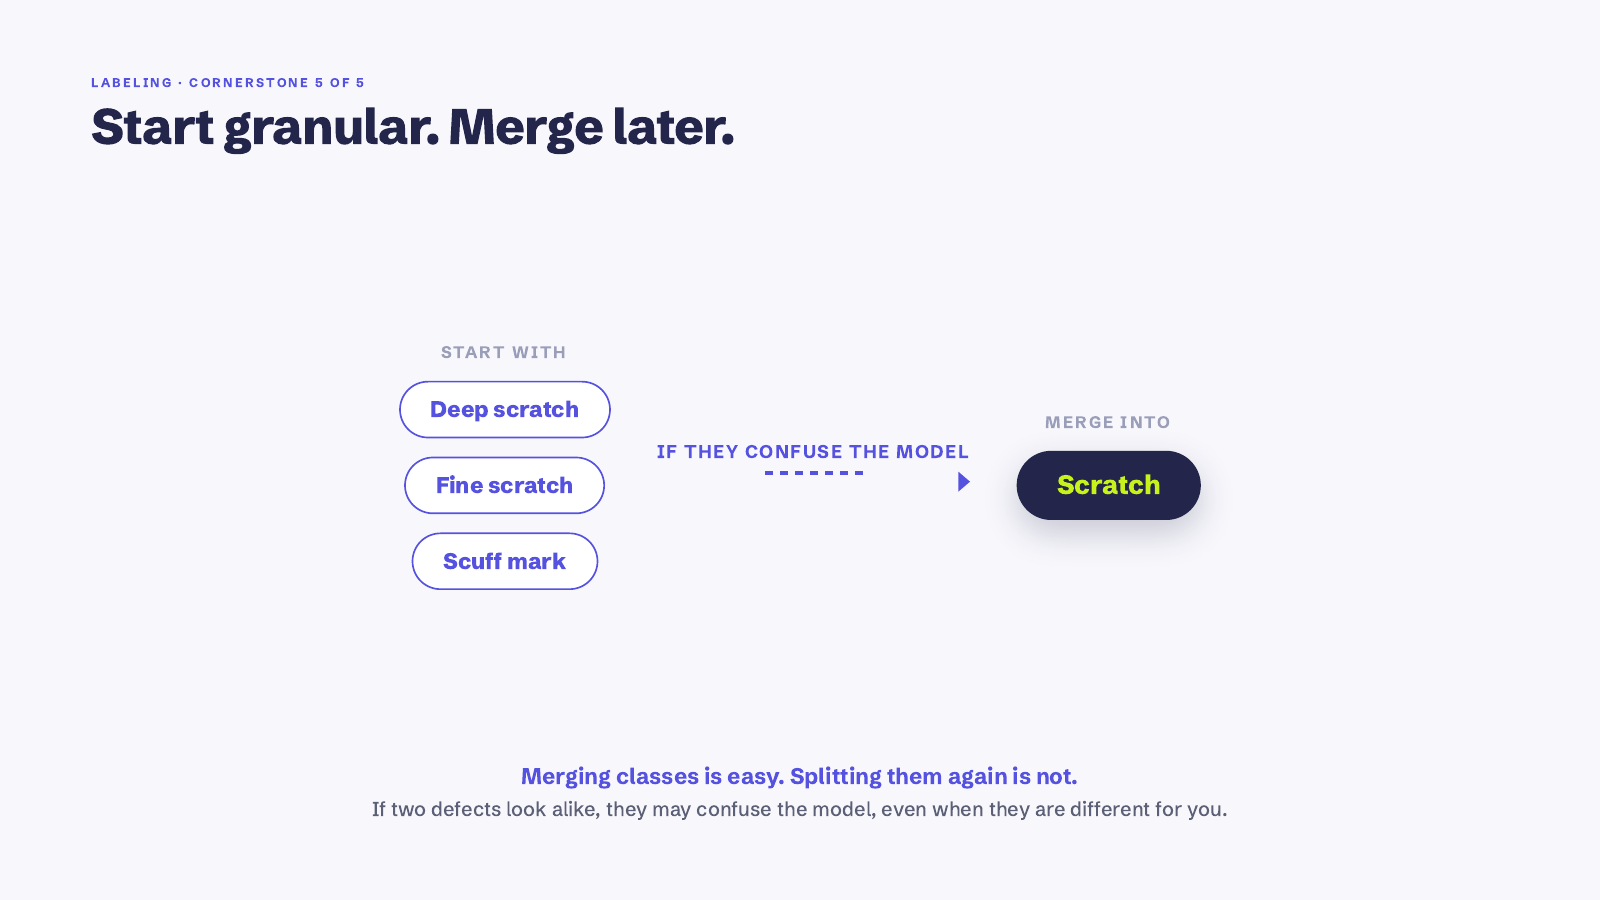
Se você não tem certeza se risco profundo, risco fino e marca de atrito são uma classe ou três, comece com três. Juntar depois é um clique. Separar uma classe que você agrupou significa revisar tudo de novo. O sinal de que é hora de juntar é quando o modelo confunde duas classes entre si o tempo todo, o que normalmente quer dizer que elas parecem iguais para a câmera, mesmo que signifiquem coisas diferentes para você.
Na prática: quatro coisas que aprendemos do jeito difícil
Os pilares são as regras. Estas são as decisões de bom senso que só aparecem quando você está de fato sentado desenhando caixas.
Muitos defeitos, uma caixa
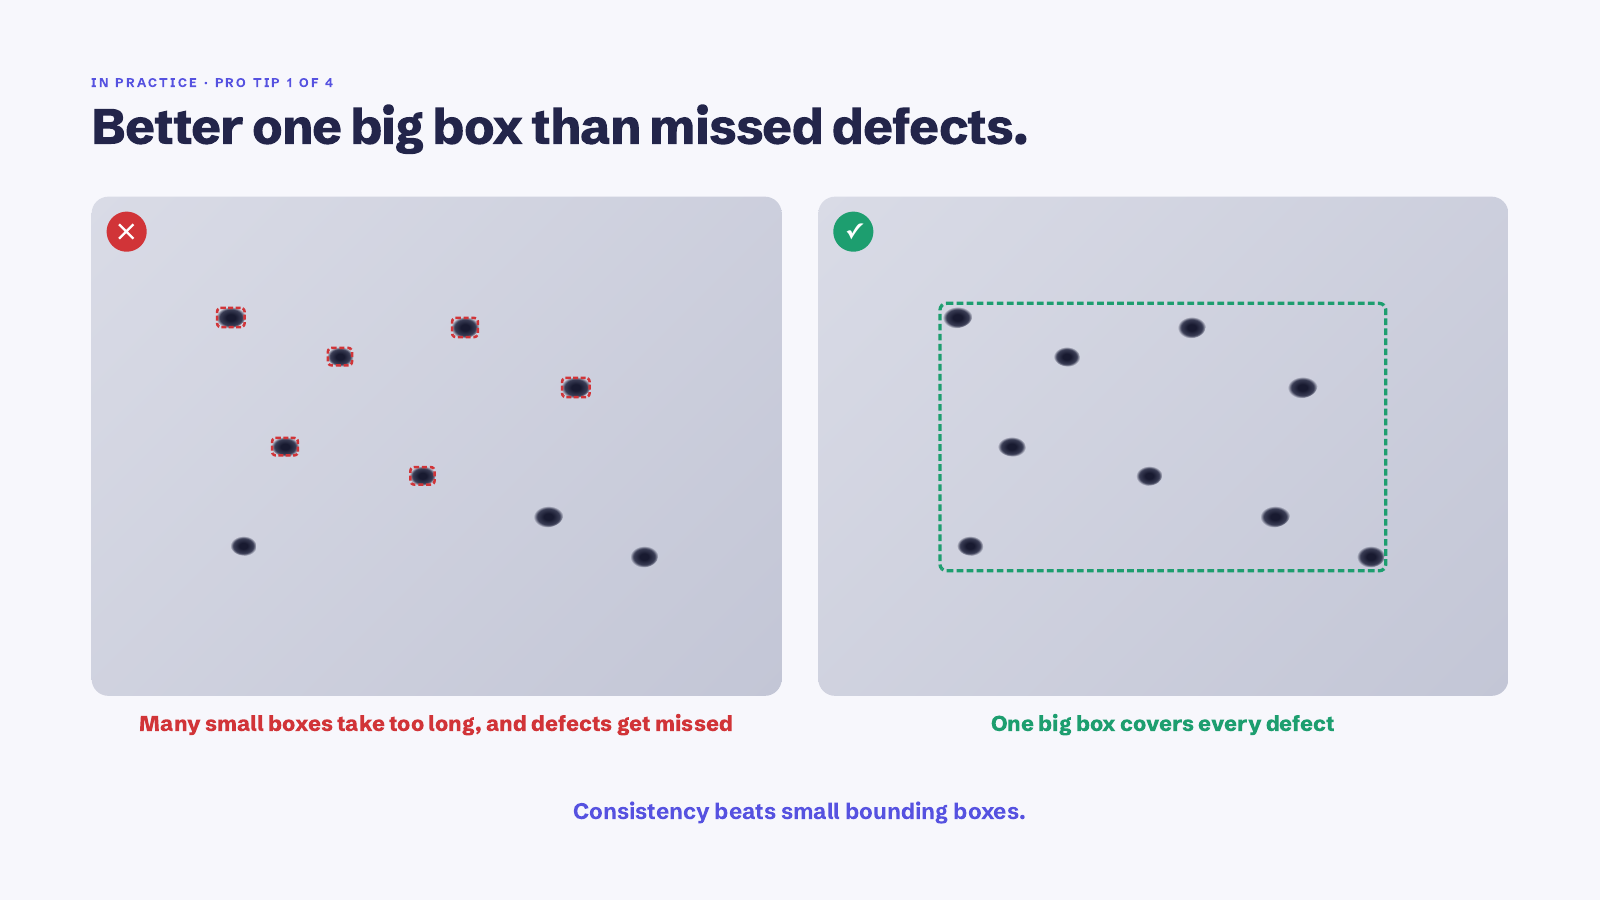
Quinze caixinhas em volta de quinze pontinhos levam uma eternidade, e lá pela caixa onze você vai esquecer um. Sabemos porque aconteceu com a gente. Uma caixa honesta em volta do aglomerado inteiro é mais rápida, e o modelo não se importa. Consistência vale mais que caixas pequenas.
Seja eficiente, não dogmático
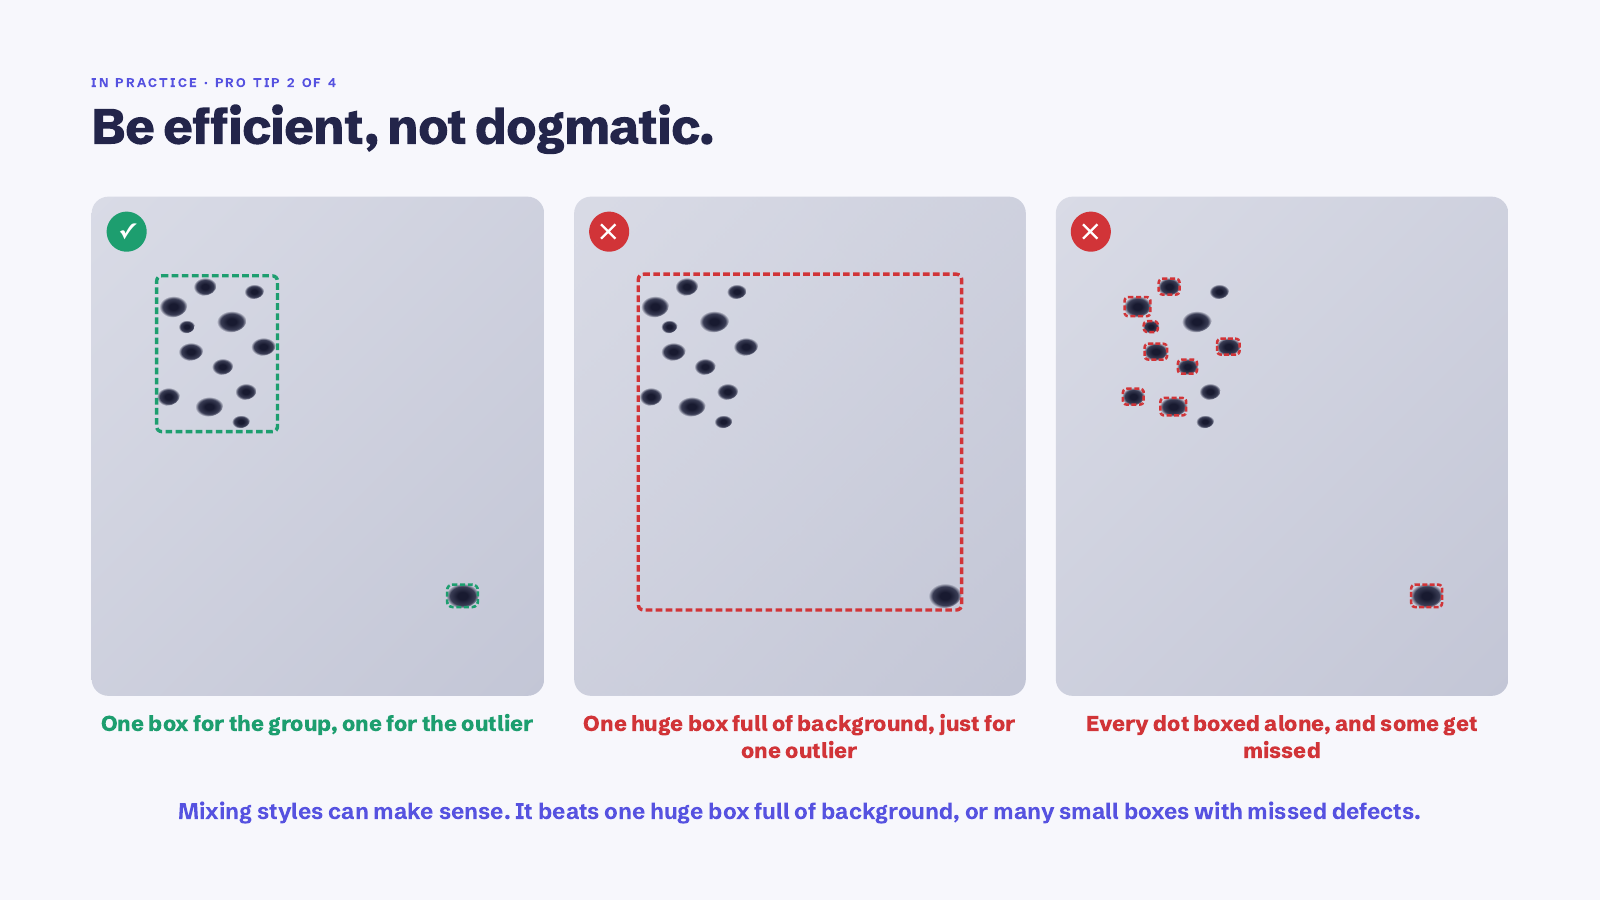
Às vezes a resposta certa é uma caixa para o grupo e outra para o ponto isolado. Sim, isso é misturar estilos. Mesmo assim é melhor do que uma caixa enorme cheia de fundo só para pegar o ponto isolado, ou quinze caixas individuais com três esquecidos. A regra por trás de todas as regras é rotular de um jeito que a próxima pessoa rotularia igual.
Tire as amostras confusas do dataset
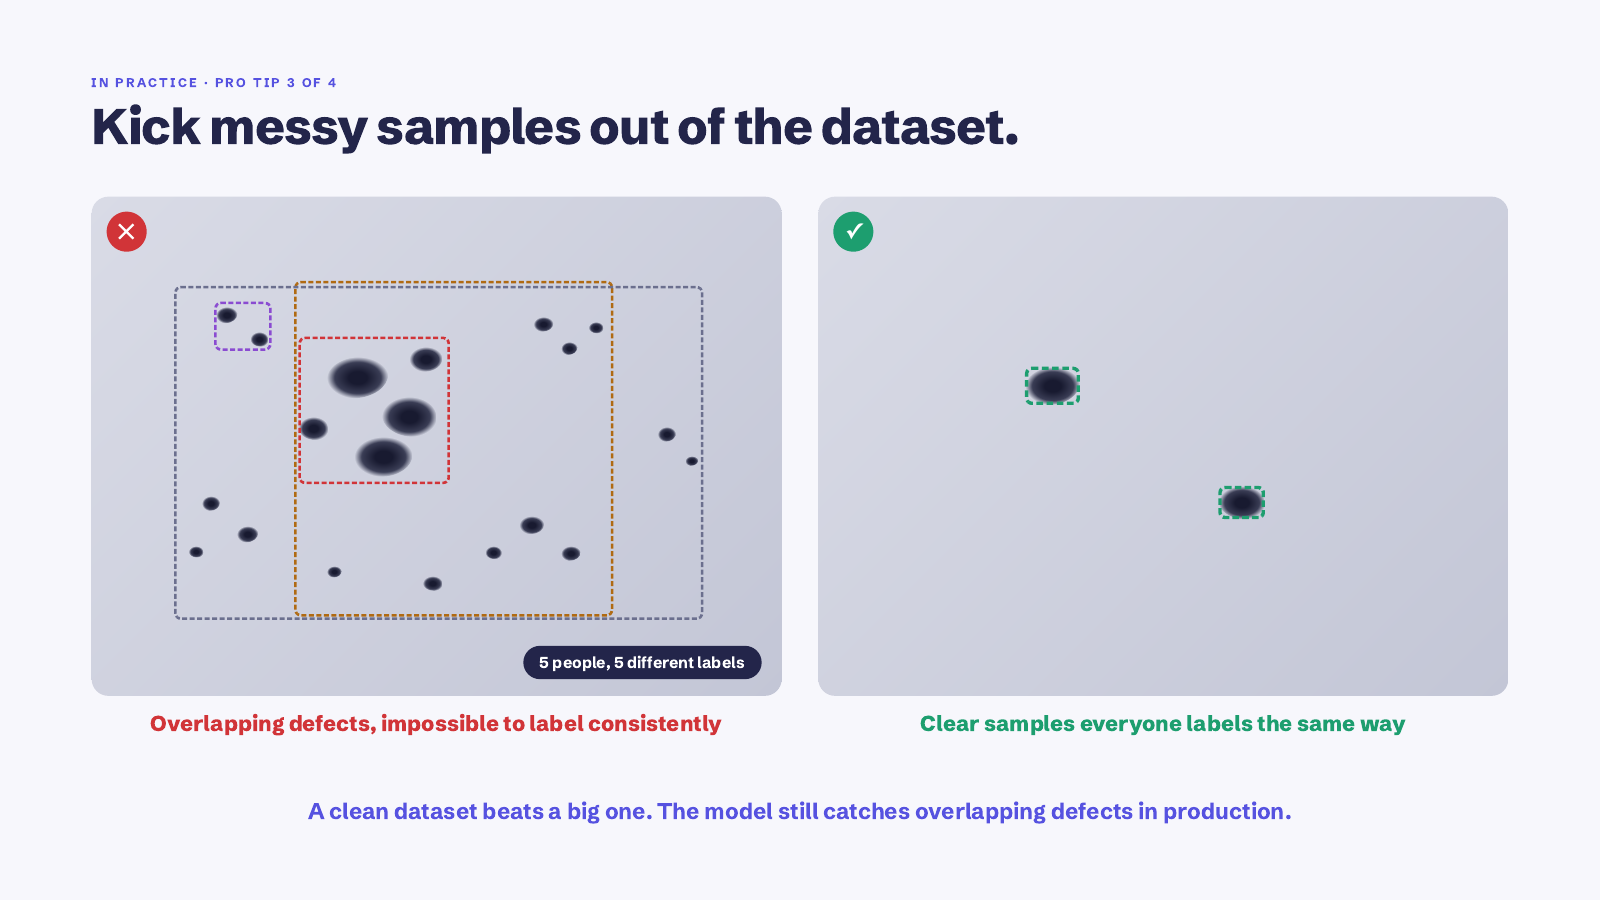
Algumas imagens são simplesmente impossíveis de rotular com consistência. Três defeitos sobrepostos, bordas que você não consegue separar, cinco pessoas que desenhariam cinco conjuntos diferentes de caixas. Tire essas imagens e não se sinta mal por isso. Um dataset limpo de duzentas imagens vale mais que um cheio de ruído com mil, e o modelo ainda vai detectar defeitos sobrepostos na produção. Ele só não deve aprender com eles.
Melhor mais fundo do que caixas subjetivas
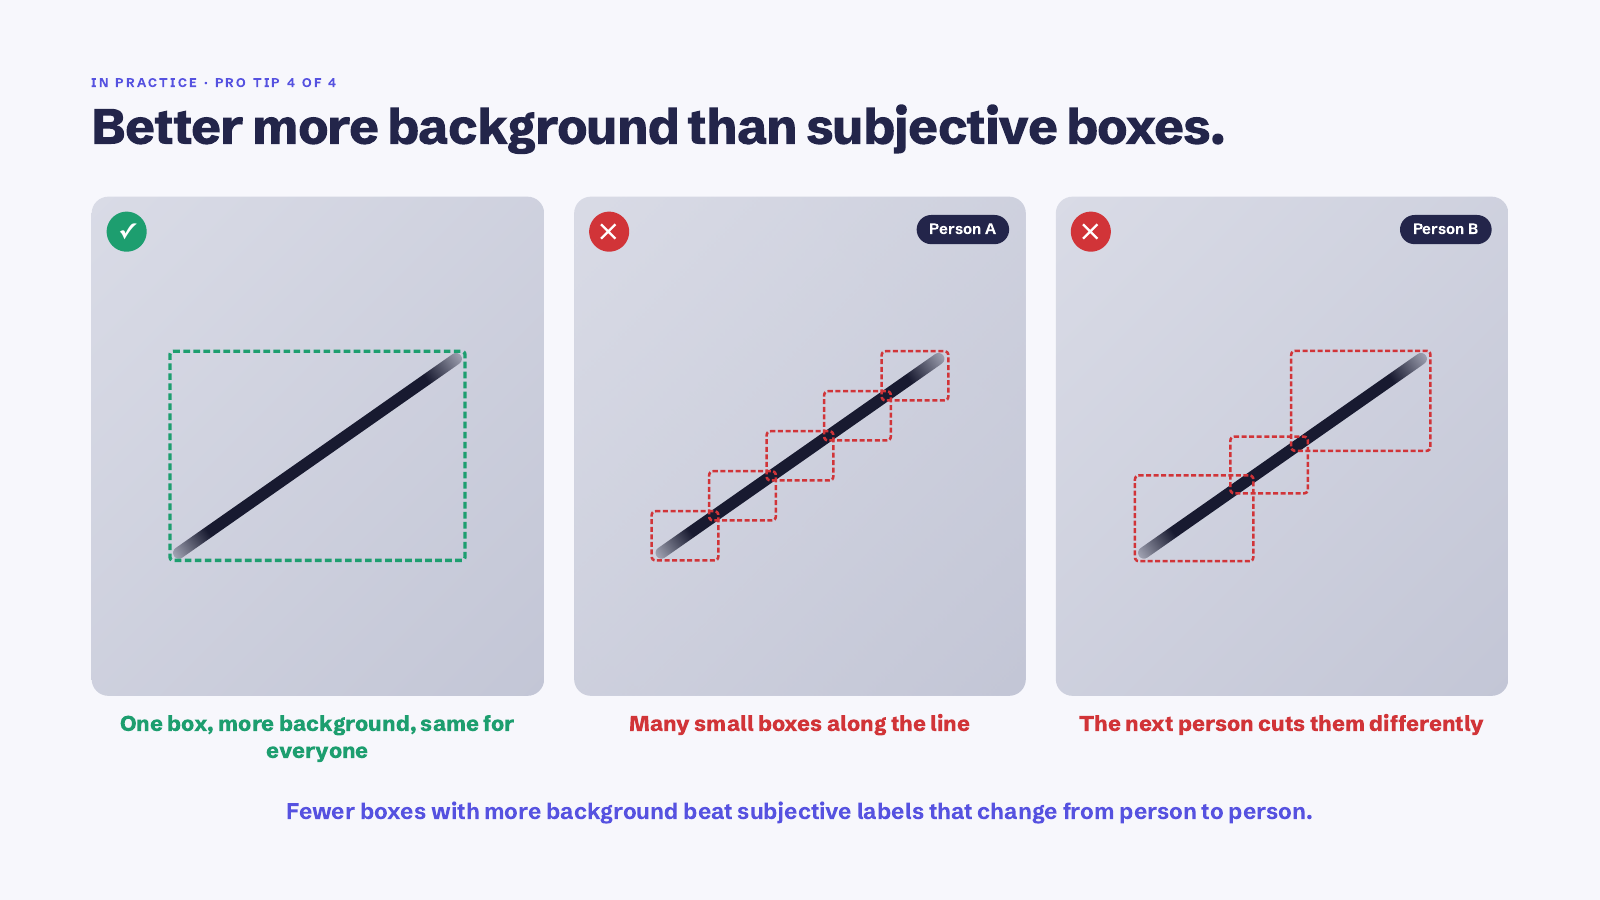
Um risco longo pode virar uma caixa ou seis curtas, e se você deixar a decisão com cada pessoa vai receber as duas coisas. Uma caixa com um pouco de fundo a mais fica igual para todo mundo. Sempre que uma decisão de rotulagem depender de quem está segurando o mouse, aumente a caixa até que deixe de depender.
De quantas imagens você precisa?
Menos do que você imagina, se forem boas. Para um tipo de defeito em um produto, 25 a 50 imagens bem rotuladas costumam bastar para um primeiro modelo que você pode colocar na linha e usar para aprender. O que costuma afundar projetos não é ter poucas imagens, é ter cem imagens rotuladas de três jeitos diferentes. Comece pequeno, rotule com cuidado, teste e depois acrescente imagens onde o modelo é mais fraco.
Perguntas frequentes
O que é anotação com bounding box?
É desenhar um retângulo, a chamada caixa delimitadora, em volta de cada coisa que você quer que o modelo encontre, neste caso cada defeito, para que ele aprenda como aquilo se parece e onde costuma aparecer. É o tipo mais comum de anotação de imagens para inspeção visual.
A caixa deve incluir fundo?
Alguns pixels de margem, não mais que isso. O suficiente para que a borda do defeito fique dentro da caixa, mas não tanto que o modelo precise aprender a ignorar o entorno.
Como rotulo um defeito que está parcialmente escondido?
Coloque a caixa só na parte que você consegue ver, bem justa. Não tente adivinhar o resto. Se a maior parte estiver escondida, pergunte a si mesmo se a imagem deveria mesmo estar no dataset.
Também preciso rotular as peças boas?
Sim, deixando-as sem caixa. Imagens sem defeitos e sem caixas ensinam ao modelo como é o normal, e você precisa delas tanto quanto das imagens com defeito.
E se duas pessoas discordarem de um rótulo?
Isso é sinal para mudar a regra, não para escolher um vencedor. Aumente a caixa, junte as classes ou descarte a amostra até que vocês dois passem a desenhar do mesmo jeito.
Teste nas suas próprias peças
A melhor forma de ver se alguma coisa disso se sustenta é rotular 25 imagens de algo da sua própria linha e treinar um modelo com elas. Teste a demo, sem cadastro, em sessenta segundos ou comece grátis.
Explore with AI
Discuss this article with your favorite AI assistant
