Defekte labeln für die KI-Sichtprüfung: ein Guide zur Bounding-Box-Annotation

Unser erstes Modell zur Defekterkennung war furchtbar, und das war unsere Schuld. Die Bilder waren in Ordnung und das Modell auch. Aber die Boxen, die wir um die Defekte gezogen hatten, waren völlig uneinheitlich, und das Modell hat genau das gelernt, was wir ihm gezeigt haben: Verwirrung.
Seitdem haben wir viele Teile gelabelt, die Leute, mit denen wir arbeiten, ebenfalls, und immer wieder tauchen dieselben paar Punkte auf. Keiner davon ist kompliziert. Die meisten sind offensichtlich, sobald jemand darauf hinweist. Genau das machen wir hier.
Kurz zusammengefasst
Fotografiere aus verschiedenen Winkeln, aus verschiedenen Abständen und bei unterschiedlichem Licht, damit das Modell den Defekt lernt und nicht den Aufbau. Dann labelst du jeden Defekt in jedem Bild, ziehst jede Box eng, labelst jedes Mal auf dieselbe Weise, lässt Boxen verschiedener Defektarten überlappen und startest mit feinen Klassen, die du später zusammenlegen kannst. In der Praxis gilt: Eine ehrliche Box schlägt zehn übersehene, unklare Bilder gehören raus aus dem Datensatz, und wenn zwei Leute eine Box unterschiedlich ziehen würden, ist sie wahrscheinlich falsch.
Fotografieren: ein Prinzip
Ein Modell verallgemeinert aus Vielfalt. Wenn jedes Bild einer Pore von derselben Stelle aus unter derselben Lampe aufgenommen wurde, lernt es genau diese Stelle und diese Lampe. Kommt dann zum ersten Mal ein leicht gedrehtes Teil, wird es nervös. Das Einzige, was sich beim Sammeln von Trainingsbildern wirklich lohnt, ist deshalb, dich zu bewegen.
Verschiedene Winkel. Geh um den Defekt herum und fotografiere ihn von mehreren Seiten. Dieselbe Pore sieht frontal anders aus als im 45-Grad-Winkel, und das Modell sollte beides kennenlernen.
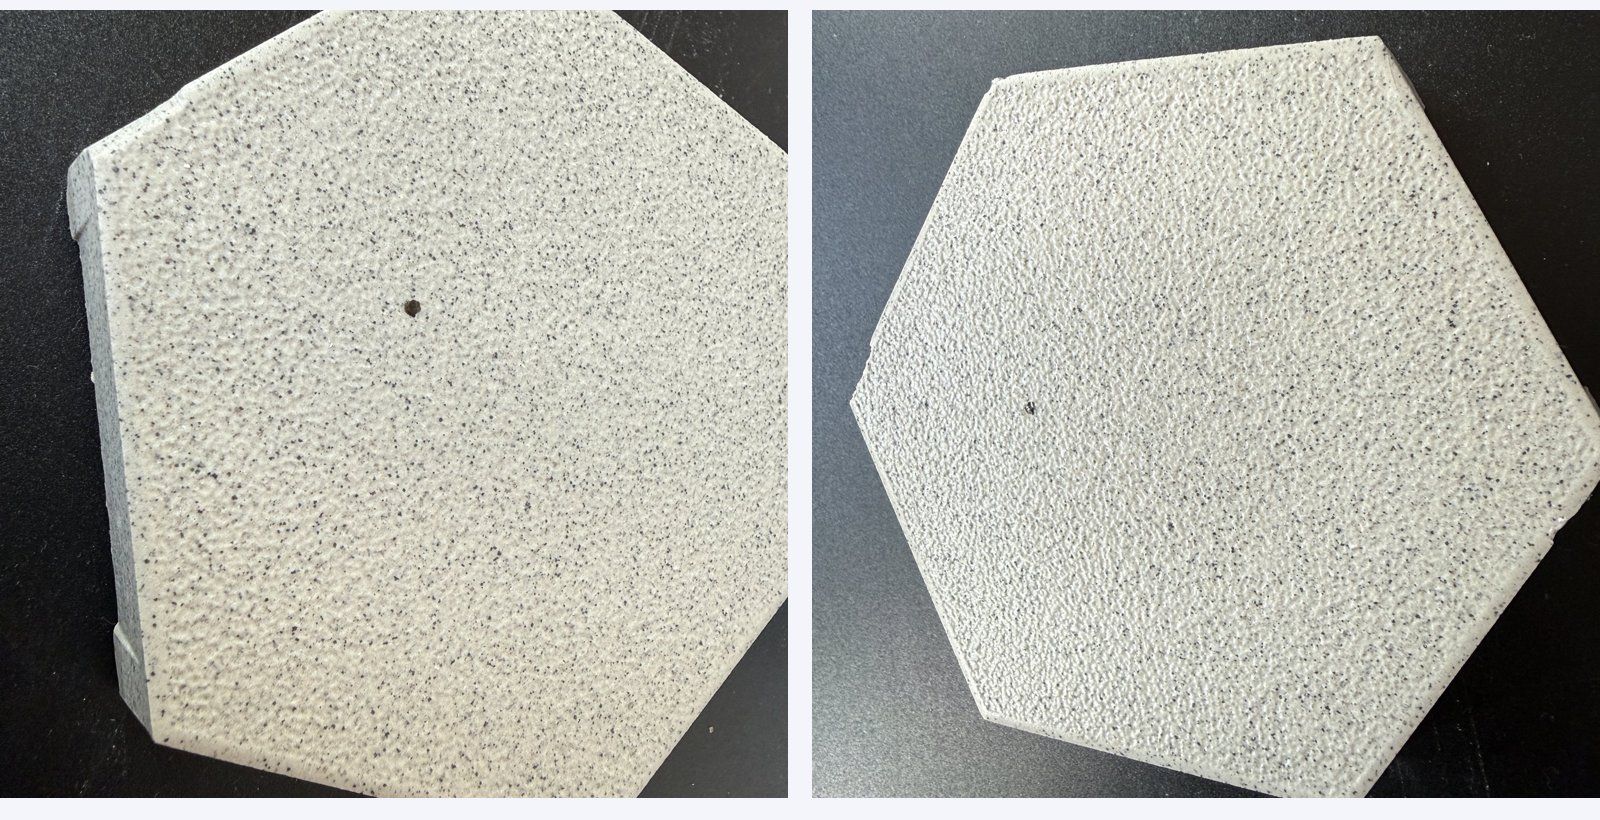
Verschiedenes Licht und verschiedene Hintergründe. Hell, gedimmt, im Schatten, auf der Werkbank, an der Linie. Nur wenn du den Hintergrund wechselst, lernt das Modell, ihn zu ignorieren.
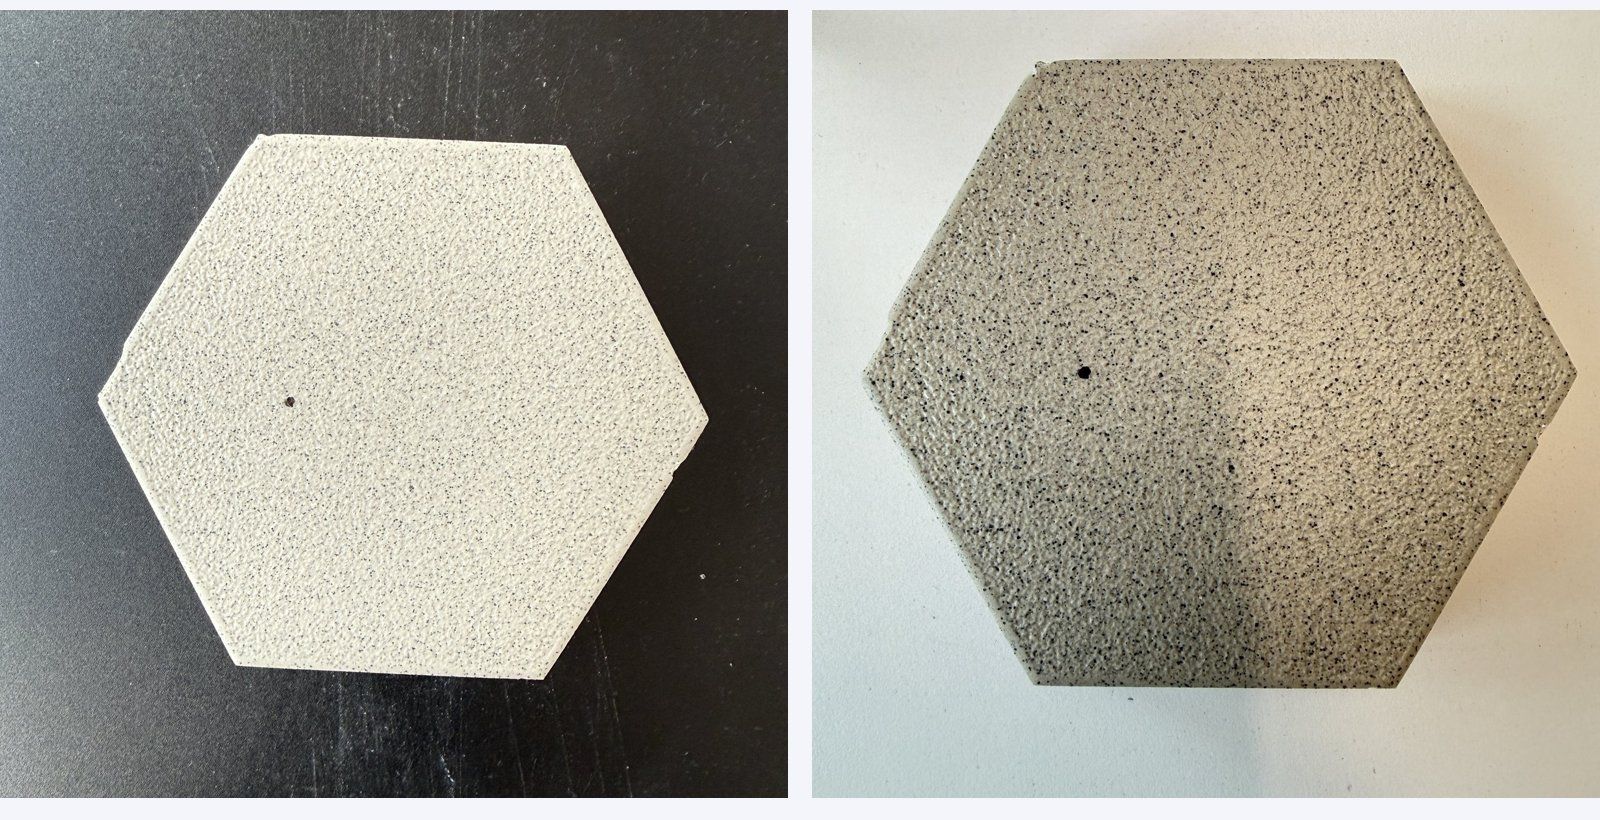
Verschiedene Abstände. Geh näher ran, geh einen Schritt zurück. Ein Defekt, der das ganze Bild füllt, und ein Defekt, der nur ein Fleck in der Ecke ist, kommen dem Modell in der Produktion beide unter.
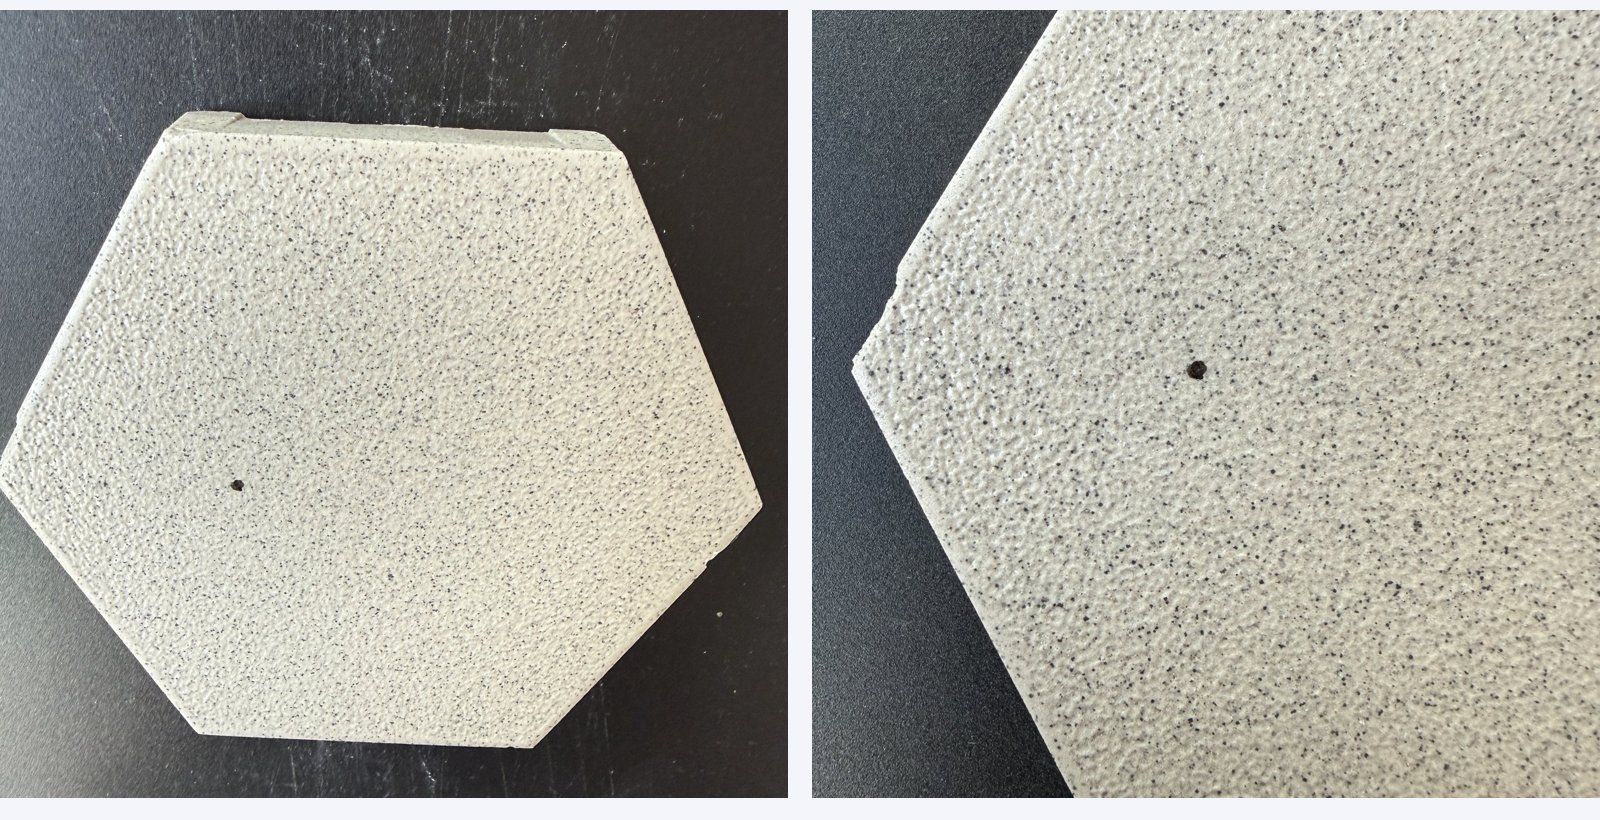
Wenn deine Kamera fest an der Linie montiert ist, ist nichts davon ein Problem. Eine feste Position liefert sehr einheitliche Bilder und ein Modell, das genau diese eine Ansicht sehr gut beherrscht. Vielfalt zählt vor allem dann, wenn du das iPhone in der Hand hältst oder wenn ein Modell mehr als eine Station abdecken muss.
Labeln: fünf Grundpfeiler
Das sind keine Enao-Regeln. Diese Regeln gelten für jede Bildannotation zur Objekterkennung, und sie machen den Unterschied zwischen einem Modell, das sich sicher ist, und einem, das dich ständig bittet, noch einmal nachzuschauen.
1. Label jeden Defekt im Bild
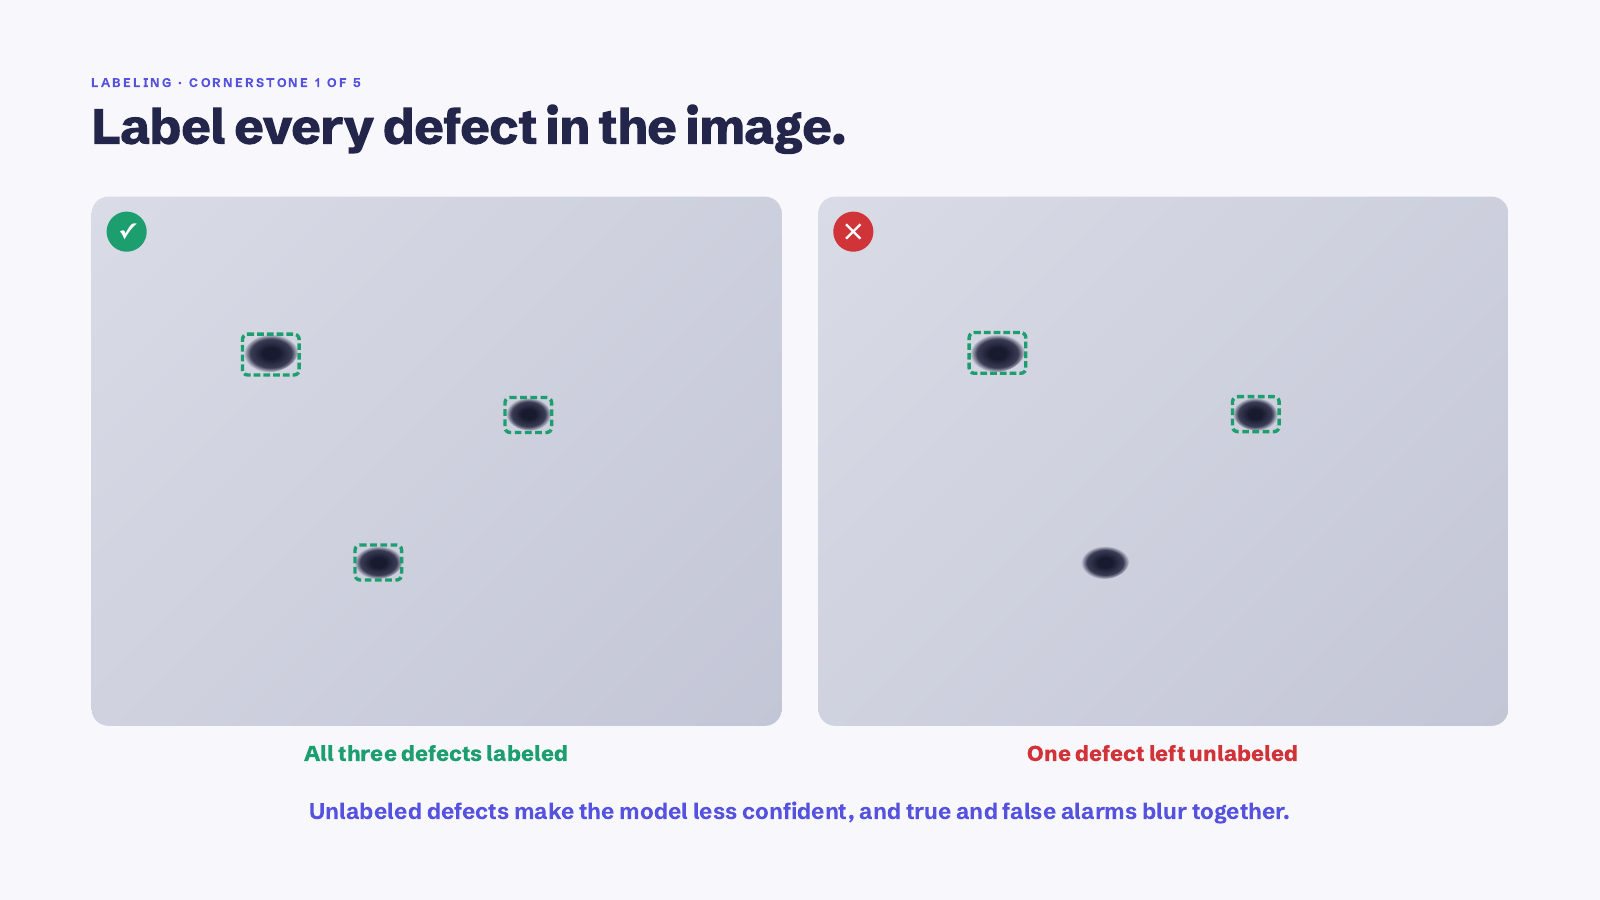
Genau hier lagen wir zuerst falsch. Wenn ein Bild drei Defekte hat und du nur zwei davon boxst, hast du dem Modell gerade gesagt, dass der dritte Hintergrund ist. Passiert das ein paar Dutzend Mal in einem Datensatz, verschwimmen echte und falsche Alarme, weil dasselbe Muster als beides gezeigt wurde. Wenn du ihn sehen kannst, bekommt er eine Box.
2. Zieh die Box eng um den Defekt
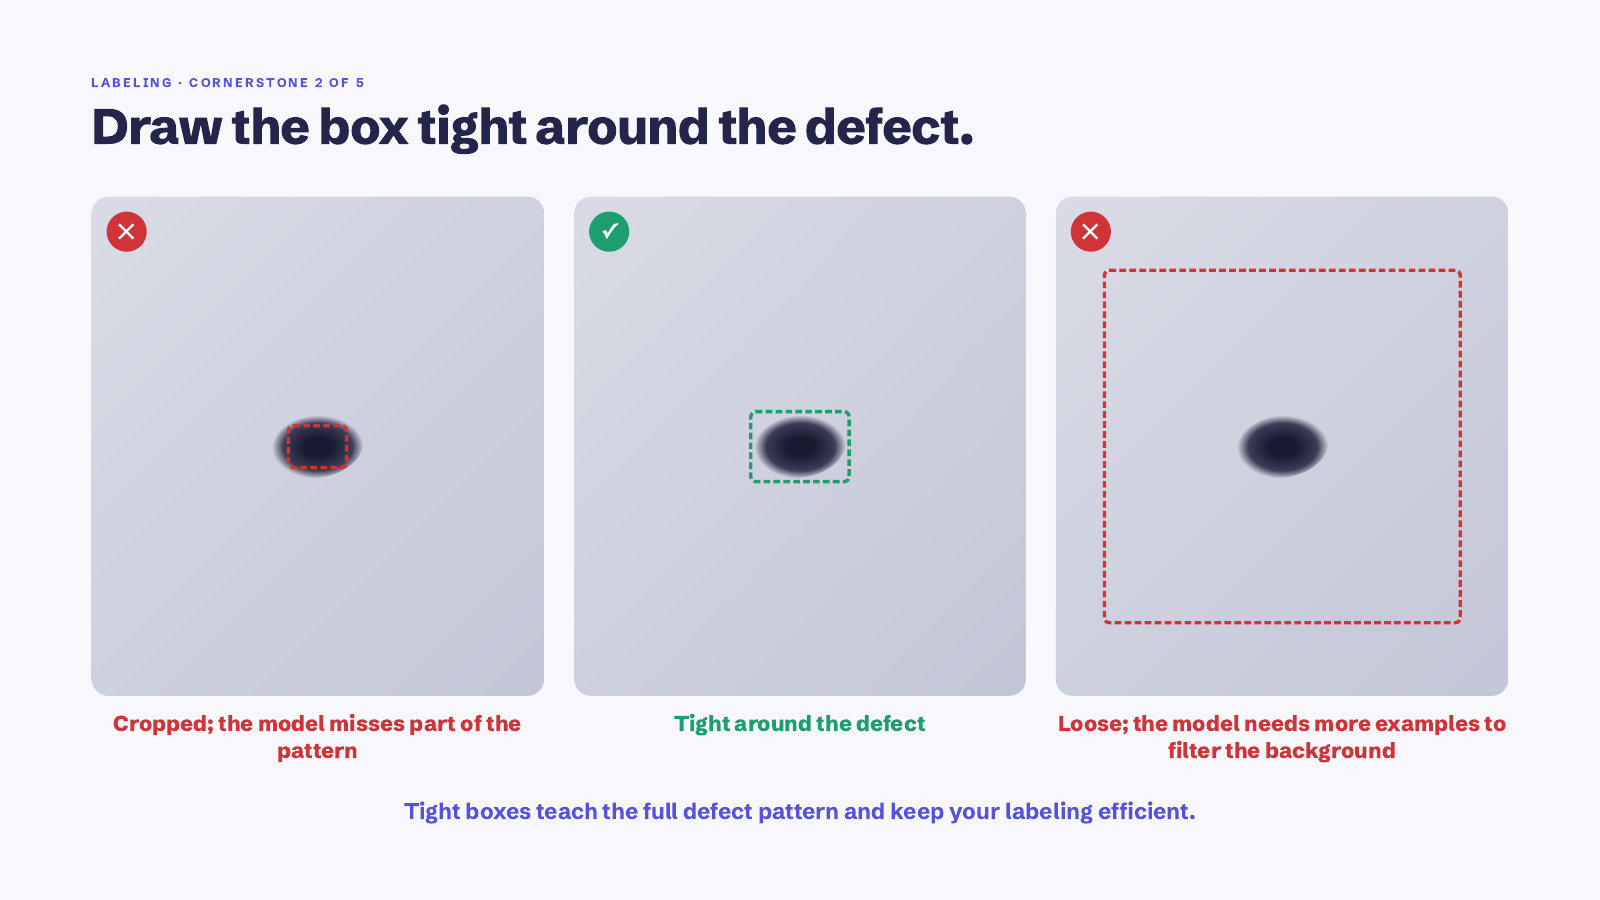
Eine enge Box mit ein paar Pixeln Rand bringt dem Modell das komplette Defektmuster bei und sonst nichts. Schneidest du zu knapp ab, fehlt ein Teil des Musters. Ziehst du sie zu locker, muss das Modell lernen, den ganzen Hintergrund zu ignorieren, und dafür braucht es mehr Beispiele, als irgendwer labeln will. Eine enge Box ist außerdem schneller gezogen, ein netter Bonus.
3. Label jedes Mal auf dieselbe Weise
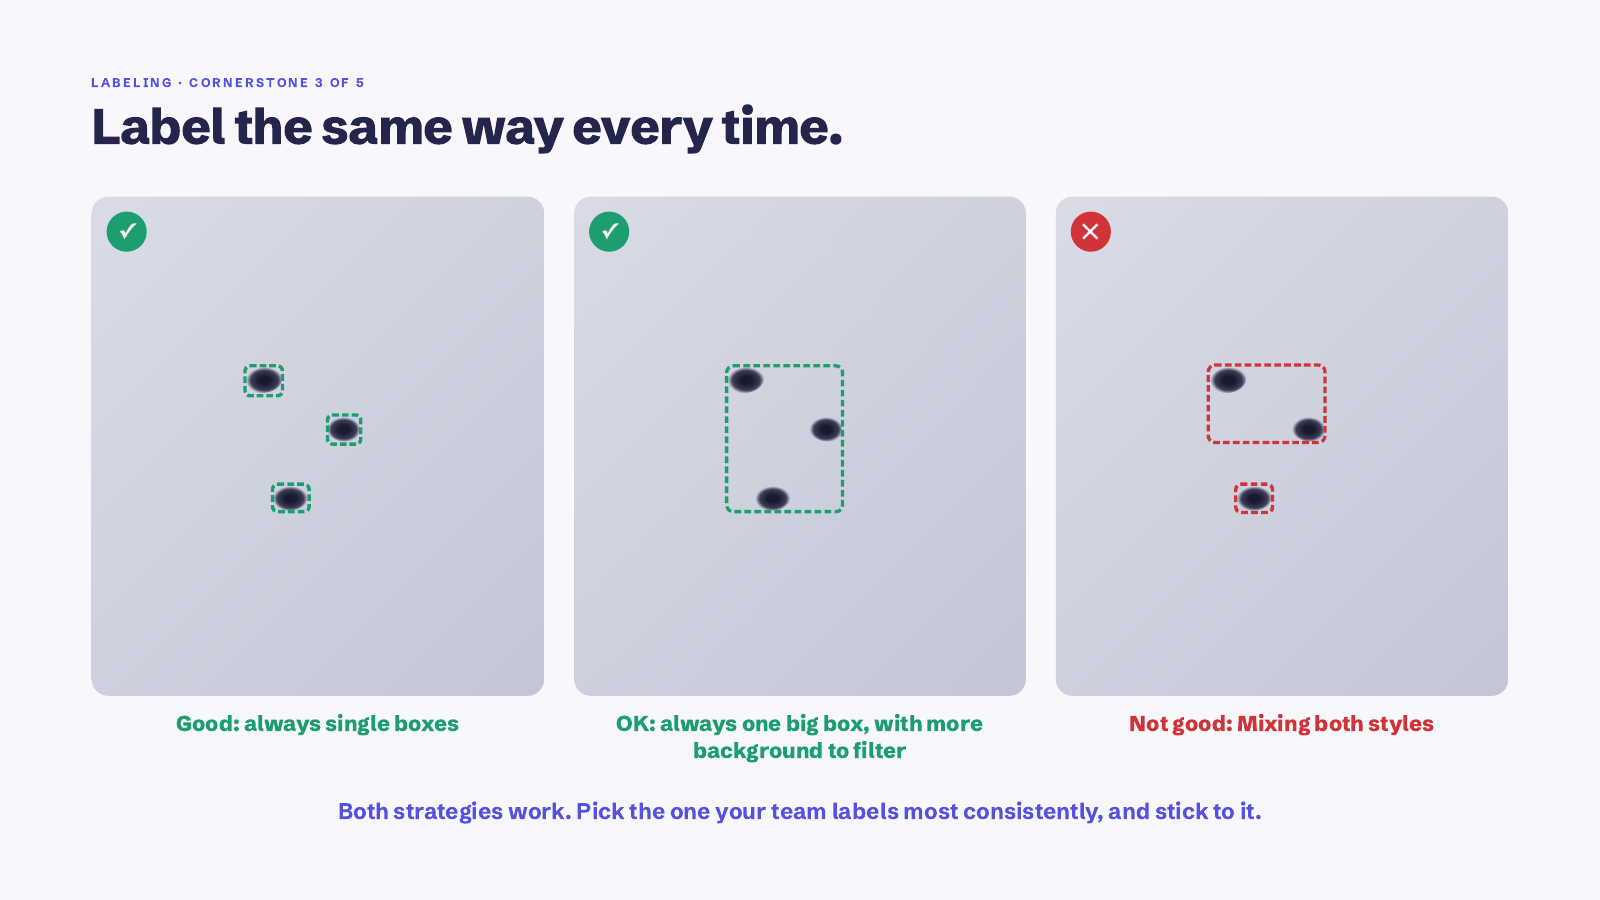
Für eine Ansammlung kleiner Defekte gibt es zwei völlig legitime Wege. Du boxst jeden einzeln oder ziehst eine Box um die ganze Gruppe. Beides funktioniert. Was nicht funktioniert, ist eine Mischung aus beidem, denn dann sieht das Modell dieselbe Situation auf zwei Arten gelabelt und kann sich nicht entscheiden. Nimm den Weg, den dein Team leichter konsequent umsetzen kann, und schreib ihn irgendwo auf.
4. Überlappende Boxen verschiedener Defekte sind okay
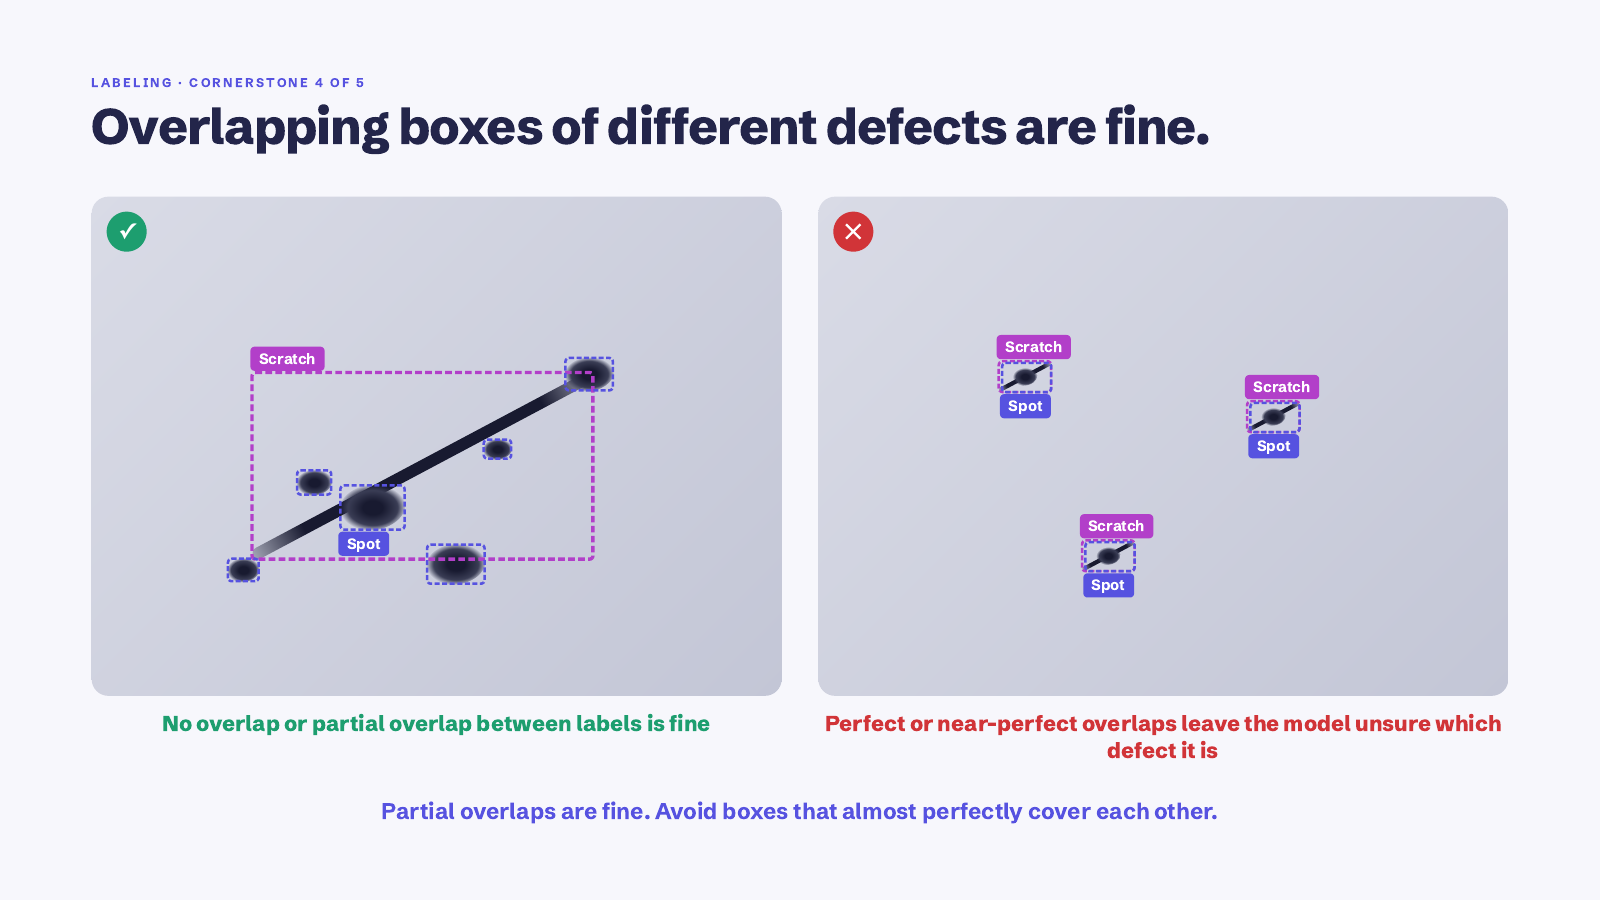
Ein Kratzer, der an einem Fleck vorbeiläuft, ist ganz normaler Alltag. Box den Kratzer, box den Fleck und lass sie überlappen. Eine teilweise Überlappung ist überhaupt kein Problem. Vermeiden solltest du zwei Boxen verschiedener Klassen, die fast exakt übereinanderliegen, denn dann kann das Modell nicht lernen, zu welcher Klasse die Pixel gehören.
5. Starte fein, fasse später zusammen
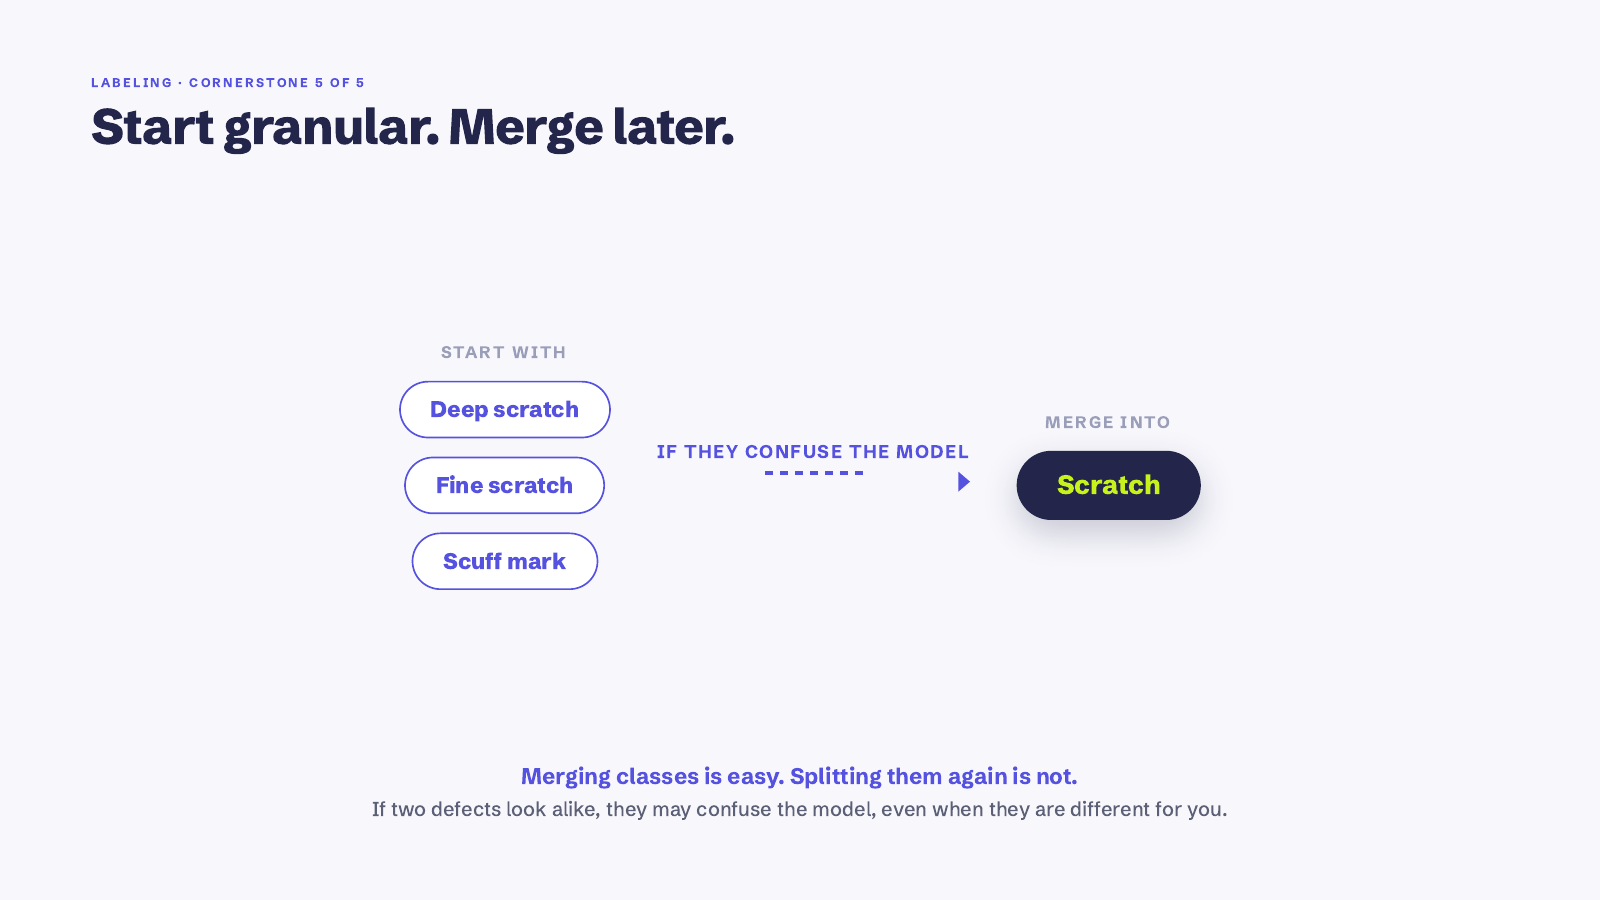
Wenn du nicht sicher bist, ob tiefer Kratzer, feiner Kratzer und Scheuerstelle eine Klasse sind oder drei, starte mit drei. Zusammenlegen ist später ein Klick. Eine Klasse aufzuteilen, die du zusammengeworfen hast, heißt dagegen, alles noch einmal durchzugehen. Zeit zum Zusammenlegen ist es, wenn das Modell zwei Klassen ständig miteinander verwechselt. Meist heißt das, dass sie für die Kamera gleich aussehen, auch wenn sie für dich etwas anderes bedeuten.
In der Praxis: vier Dinge, die wir auf die harte Tour gelernt haben
Die Grundpfeiler sind die Regeln. Das hier sind die Ermessensfragen, die erst auftauchen, wenn du wirklich dasitzt und Boxen ziehst.
Viele Defekte, eine Box
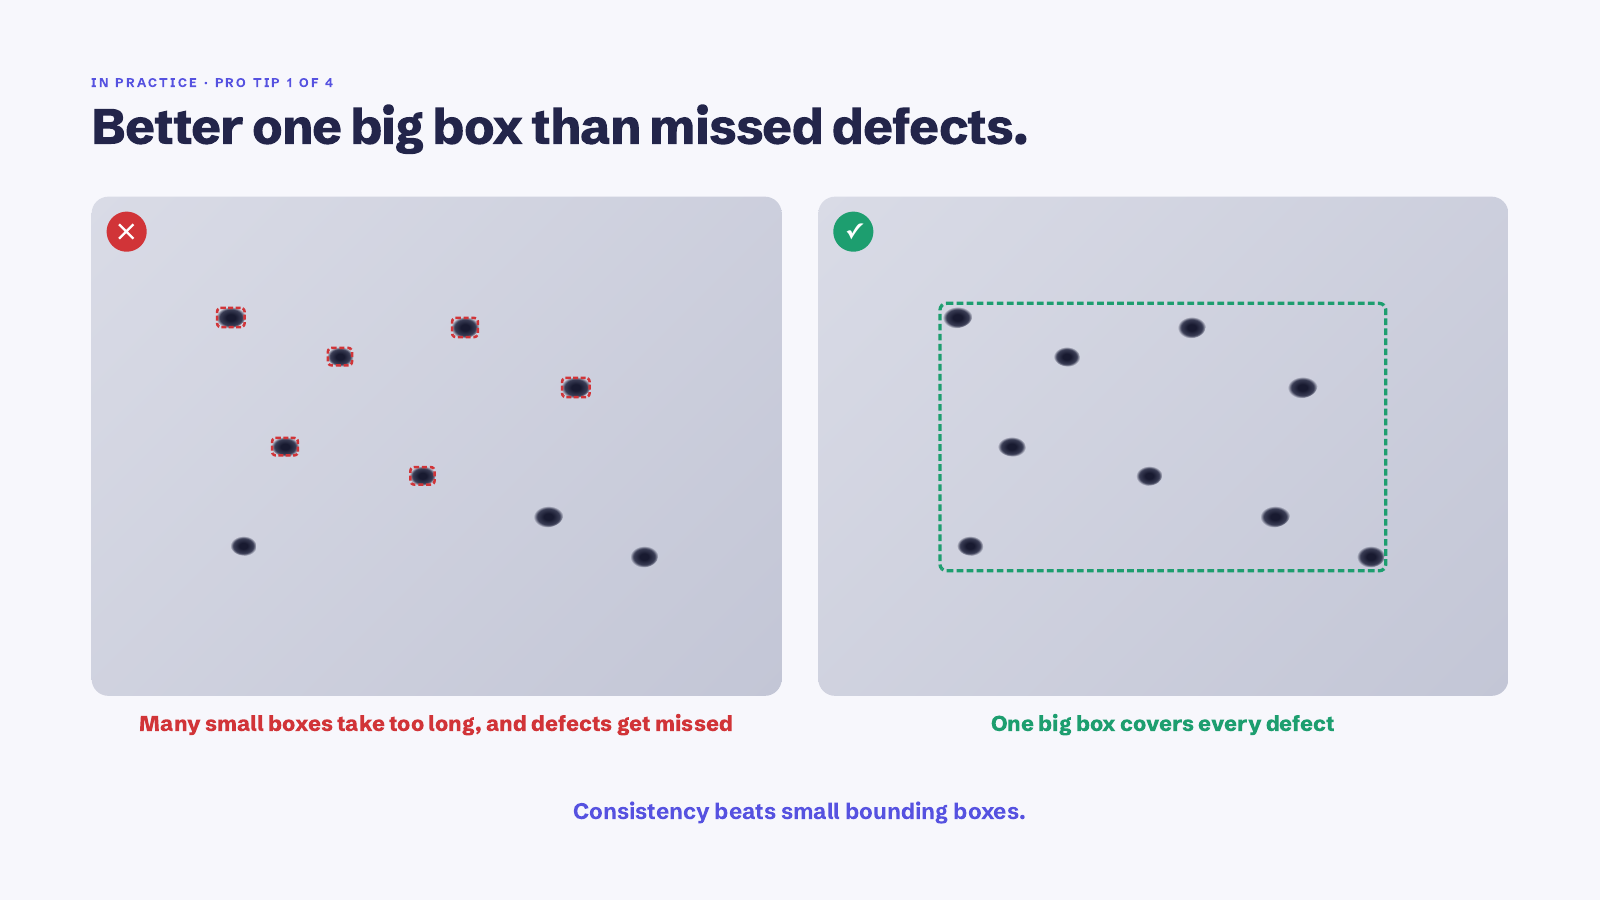
Fünfzehn winzige Boxen um fünfzehn Pünktchen dauern ewig, und irgendwo um Box elf herum übersiehst du einen. Wir wissen das, weil es uns selbst passiert ist. Eine ehrliche Box um die ganze Ansammlung geht schneller, und das Modell stört das nicht. Konsistenz schlägt kleine Boxen.
Sei effizient, nicht dogmatisch
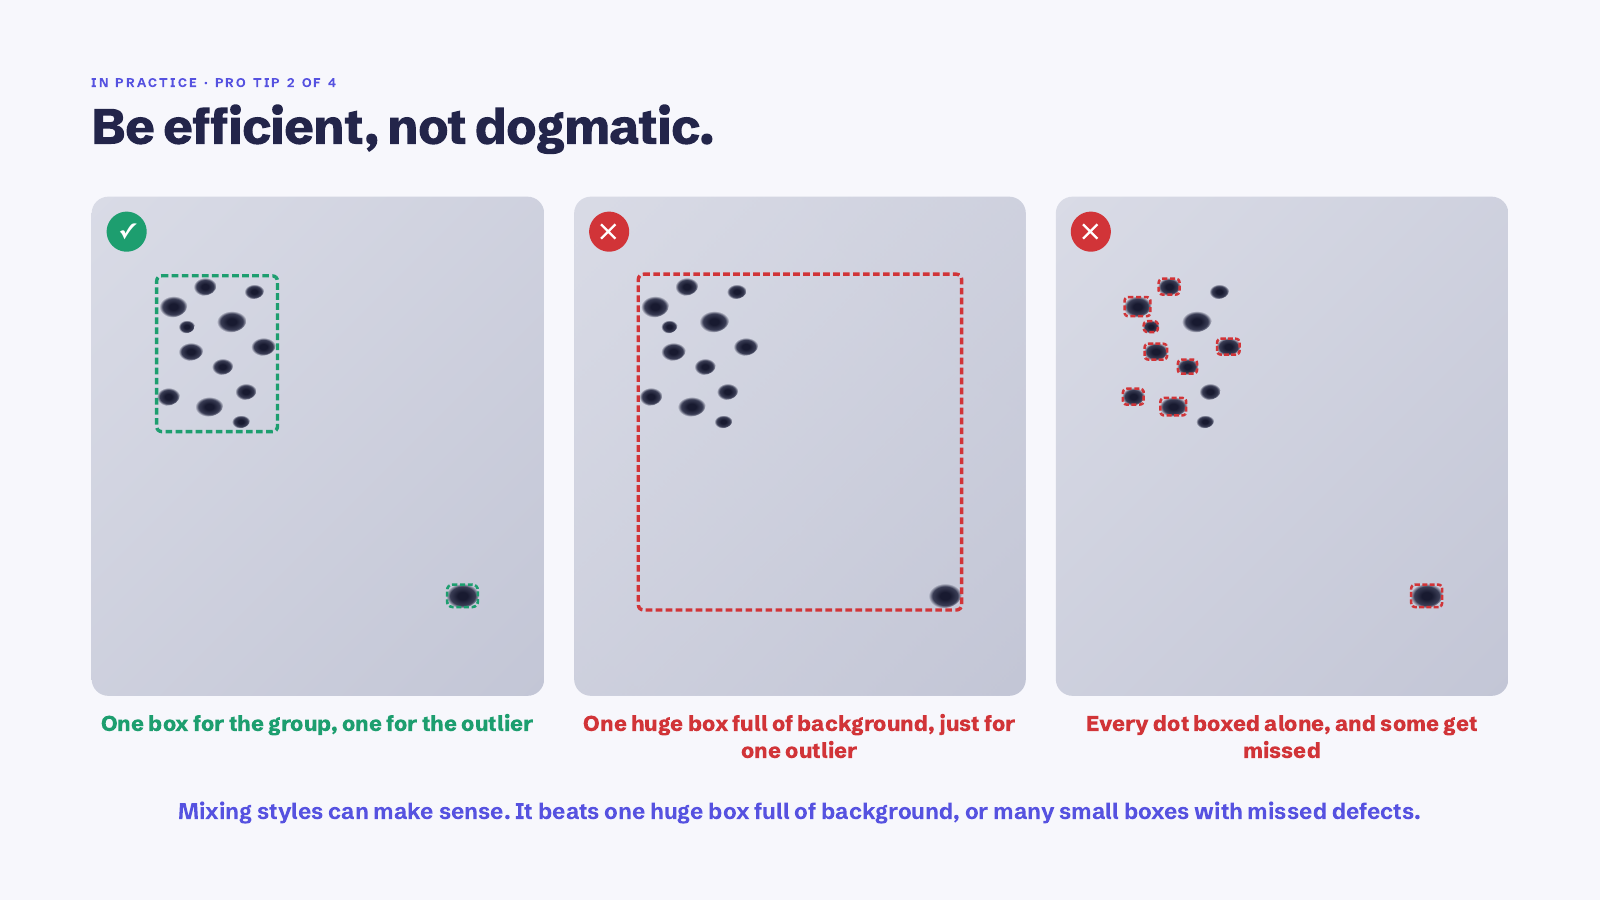
Manchmal ist die richtige Antwort eine Box für die Gruppe und eine für den Ausreißer. Ja, das ist ein gemischter Stil. Es ist trotzdem besser als eine riesige Box voller Hintergrund, nur um den Ausreißer mitzunehmen, oder fünfzehn einzelne Boxen, von denen drei fehlen. Die Regel hinter allen Regeln lautet: Label so, dass die nächste Person es genauso labeln würde.
Wirf unklare Bilder aus dem Datensatz
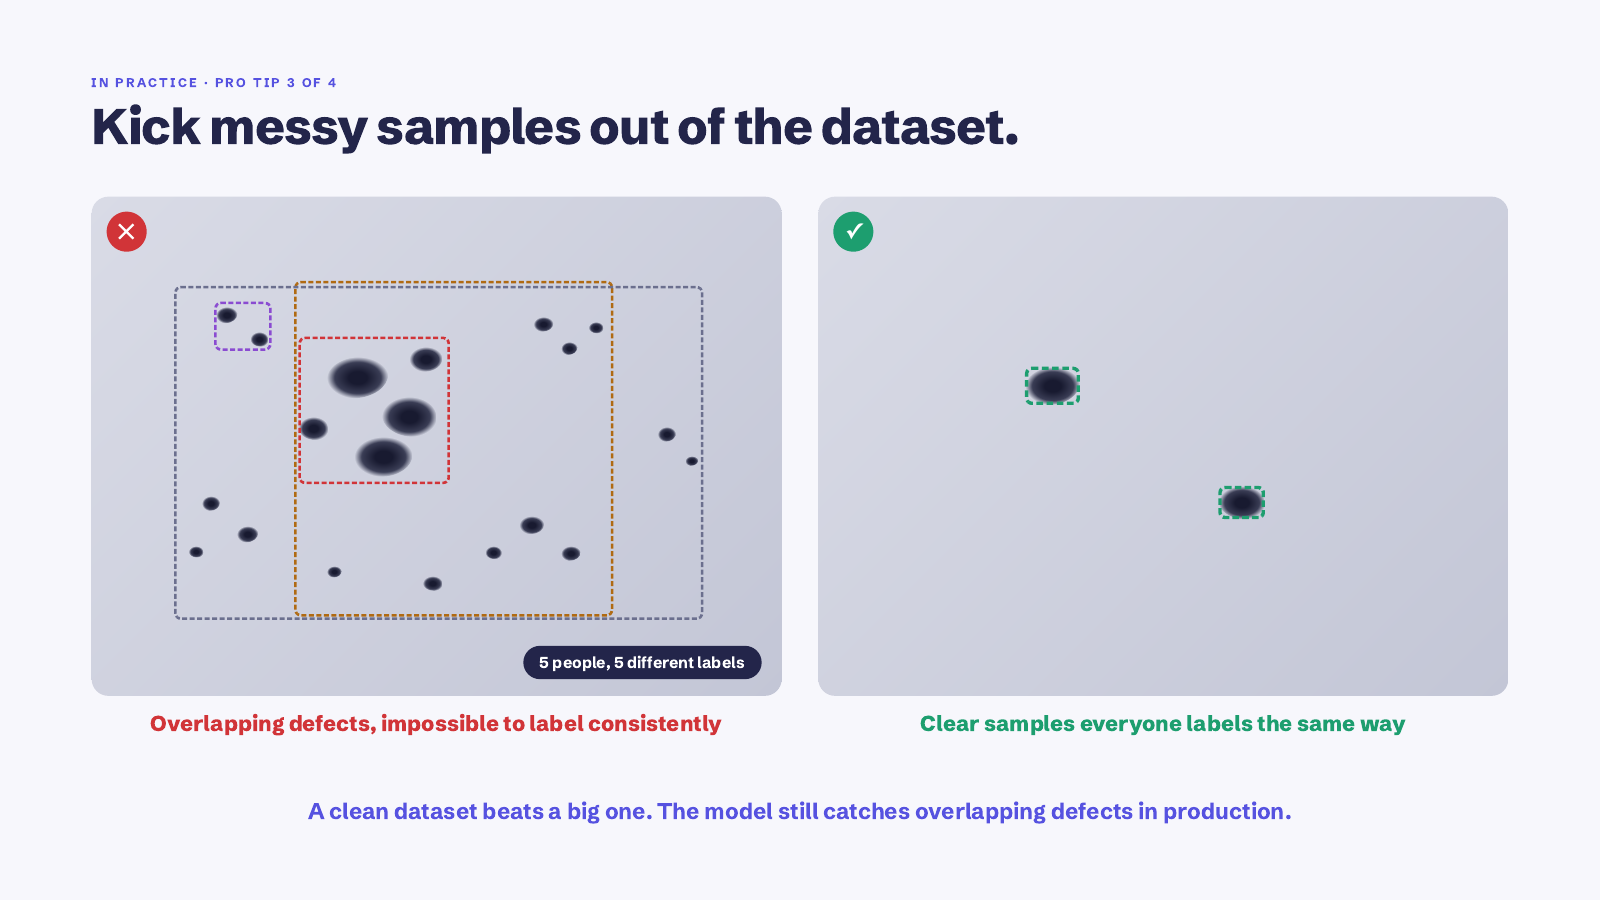
Manche Bilder lassen sich einfach nicht konsistent labeln. Drei Defekte überlappen, Kanten lassen sich nicht trennen, fünf Leute würden fünf verschiedene Sets von Boxen ziehen. Nimm diese Bilder raus und hab kein schlechtes Gewissen dabei. Ein sauberer Datensatz mit zweihundert Bildern schlägt einen verrauschten mit tausend, und das Modell erkennt überlappende Defekte in der Produktion trotzdem. Es sollte nur nicht aus ihnen lernen.
Lieber mehr Hintergrund als subjektive Boxen
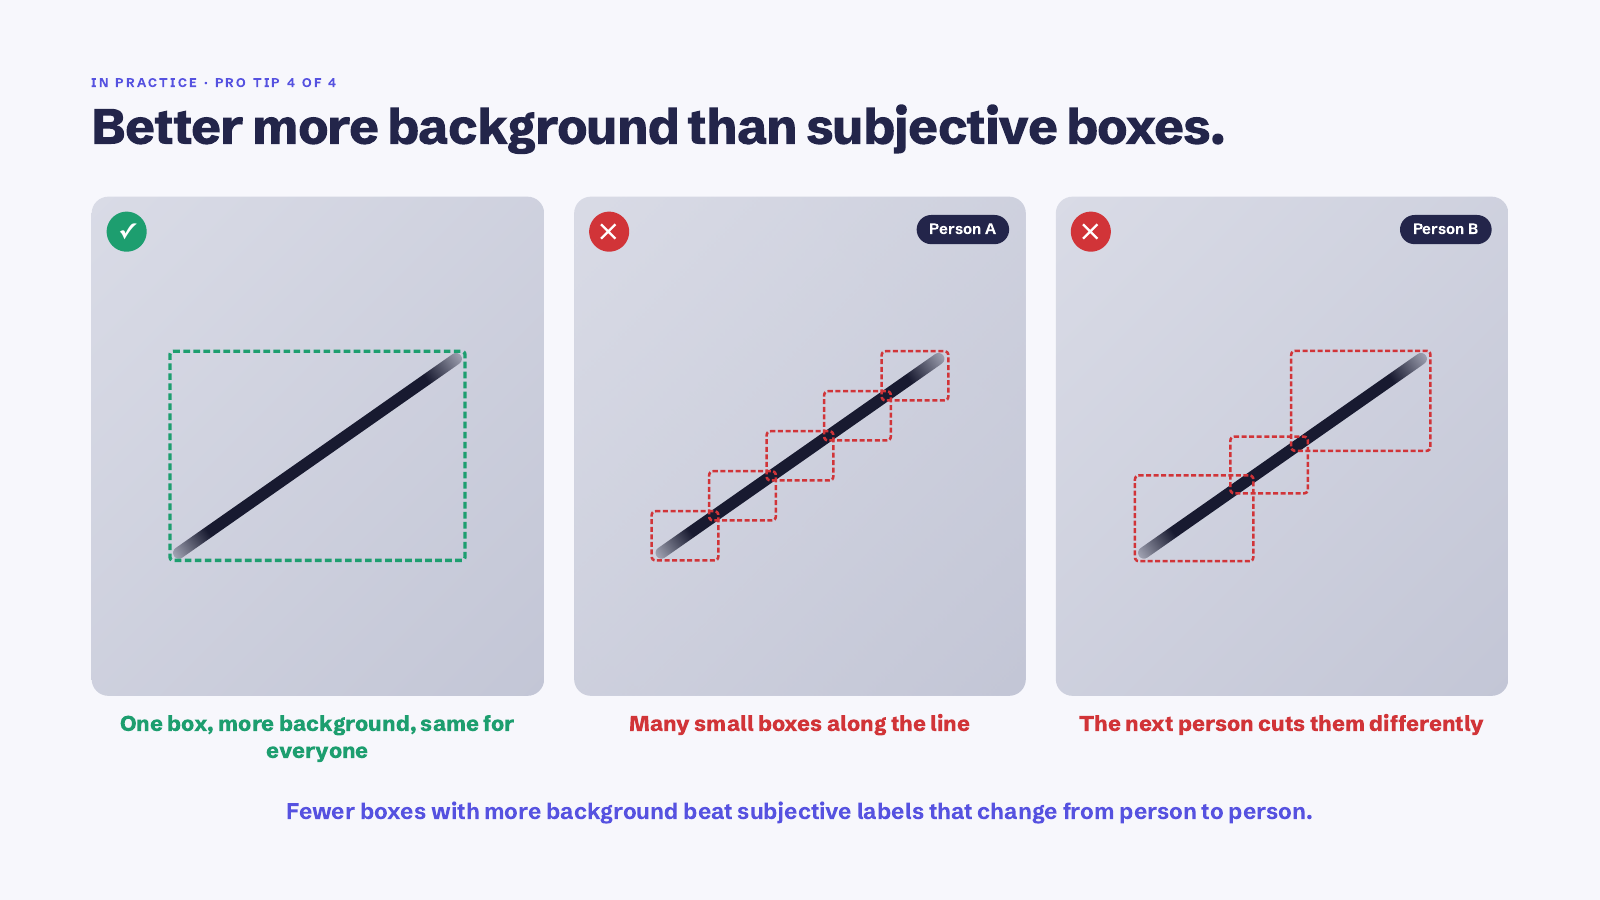
Ein langer Kratzer kann eine Box sein oder sechs kurze, und wenn du das jedem selbst überlässt, bekommst du beides. Eine Box mit etwas zusätzlichem Hintergrund ist für alle gleich. Immer wenn eine Labeling-Entscheidung davon abhängt, wer gerade die Maus hält, mach die Box größer, bis sie nicht mehr davon abhängt.
Wie viele Bilder brauchst du?
Weniger, als du vielleicht denkst, wenn sie gut sind. Für eine Defektart an einem Produkt reichen meist 25 bis 50 gut gelabelte Bilder für ein erstes Modell, das du an die Linie bringen und aus dem du lernen kannst. Projekte scheitern selten an zu wenigen Bildern, sondern an hundert Bildern, die auf drei verschiedene Arten gelabelt wurden. Fang klein an, label sorgfältig, teste und füge dann Bilder dort hinzu, wo das Modell am schwächsten ist.
FAQ
Was ist Bounding-Box-Annotation?
Du ziehst ein Rechteck um alles, was das Modell finden soll, in diesem Fall um jeden Defekt, damit es lernt, wie das aussieht und wo es typischerweise auftaucht. Das ist die häufigste Art der Bildannotation für die Sichtprüfung.
Sollte die Box Hintergrund enthalten?
Ein paar Pixel Rand, mehr nicht. Genug, dass die Kante des Defekts in der Box liegt, aber nicht so viel, dass das Modell lernen muss, die Umgebung zu ignorieren.
Wie labele ich einen Defekt, der teilweise verdeckt ist?
Box den sichtbaren Teil, und zwar eng. Rate nicht, wie der Rest aussieht. Wenn der Großteil verdeckt ist, frag dich, ob das Bild überhaupt in den Datensatz gehört.
Labele ich auch Gutteile?
Ja, indem du sie ohne Box lässt. Bilder ohne Defekte und ohne Boxen zeigen dem Modell, wie normal aussieht, und die brauchst du genauso wie die Bilder mit Defekten.
Was, wenn zwei Leute sich bei einem Label nicht einig sind?
Das ist ein Zeichen, die Regel zu ändern, nicht einen Gewinner zu küren. Mach die Box größer, fasse die Klassen zusammen oder lass das Bild weg, bis ihr beide die Box gleich ziehen würdet.
Probier es an deinen eigenen Teilen aus
Am besten findest du heraus, ob das alles stimmt, indem du 25 Bilder von etwas an deiner eigenen Linie labelst und ein Modell darauf trainierst. Probier die Demo aus, ohne Anmeldung, in sechzig Sekunden oder starte kostenlos.
Explore with AI
Discuss this article with your favorite AI assistant
